

Технологические метрики для бизнеса — это измеримые показатели работы IT-систем, команд и цифровых процессов, которые помогают руководителям принимать обоснованные решения. Они переводят техническую деятельность на язык бизнеса: деньги, скорость, качество. Правильно выбранные метрики позволяют выявлять узкие места, снижать риски и повышать эффективность компании. В этой статье разберём, какие показатели действительно важны, а какие лишь создают иллюзию контроля.
Почему метрики нужны, а не «для галочки»
Любая система управления опирается на факты. Когда владелец говорит «IT у нас работает нормально», он опирается на эмоции. Когда он видит цифру доступности сервисов 99,9% и время реакции на инциденты — 15 минут, он получает объективную картину. Разница между этими подходами огромна.
Метрики нужны не для контроля ради контроля. Они показывают, куда движется компания. Отдел разработки может отчитываться о тысячах выполненных задач, но если при этом время вывода новых функций на рынок выросло с двух недель до двух месяцев, бизнес теряет позиции. Без метрик этот разрыв останется незамеченным.
Хорошая метрика — это ответ на вопрос: «Как наша технологическая работа влияет на деньги и клиентов?»
Вредные метрики и мифы вокруг них
Существует заблуждение, что любые измеримые показатели полезны. На практике часть метрик приносит больше вреда, чем пользы. Классический пример — количество строк кода. Если поощрять разработчиков за объём написанного, они будут писать длинный и сложный код вместо простого и понятного. Аналогично работает метрика «количество звонков в поддержку»: она стимулирует создавать больше обращений, а не решать проблемы клиентов.
Миф о том, что «всё можно измерить», тоже опасен. Креативность, инженерную культуру, доверие в команде невозможно выразить одним числом. Попытка оцифровать такие категории приводит к манипуляциям и формализму. Сотрудники начинают «играть по цифрам» вместо того, чтобы делать свою работу хорошо. Этот эффект известен как закон Гудхарта: когда показатель становится целью, он перестаёт быть объективным измерителем. Если сотрудники знают, что их оценивают по конкретному числу, они оптимизируют именно его, а не реальную работу.
По данным Gartner, около 63% организаций продолжают отслеживать значения, которые не коррелируют с финансовым успехом бизнеса, а 64% компаний выбирают изначально неверные ориентиры, что приводит к потере до 30% продуктивности команд Gartner. Исследования Standish Group показывают: более 50% проектов сталкиваются с задержками из-за проблем в командной работе, что подчёркивает важность корректно выбранных метрик Standish Group.
Ещё один миф — «чем больше метрик, тем лучше контроль». На самом деле обилие показателей перегружает внимание. Руководитель тонет в дашбордах и перестаёт видеть главное. Эффективнее держать под контролем 5–7 показателей, которые действительно отражают здоровье IT-функции.
Vanity-метрики и их скрытая опасность
Vanity-метрики — это цифры, которые выглядят внушительно, но не влияют на результат. Типичные примеры: общее количество зарегистрированных пользователей, число запущенных серверов, объём потраченного бюджета. Сами по себе они не говорят о том, зарабатывает ли компания больше денег или работает эффективнее.
Опасность таких метрик в том, что они создают ложное ощущение прогресса. Руководитель видит растущий график и успокаивается, а реальные проблемы остаются незамеченными. Например, увеличение количества инцидентов может быть связано с ростом числа пользователей — это нормально. Но если считать только абсолютное число, без привязки к объёму трафика, выводы будут неверными.
Чтобы не попасть в ловушку vanity-метрик, задавайте себе вопрос: «Как эта цифра связана с целями бизнеса?». Если связь не прослеживается, скорее всего, перед вами пустышка. Легко отчитаться о «проведённой цифровой трансформации», но гораздо сложнее показать, как она повлияла на выручку или издержки.
Как метрики помогают принимать решения и синхронизировать команды
Метрики выполняют три функции. Диагностика — это выявление проблем до того, как они станут критическими. Например, рост времени отклика сервера на 20% может сигнализировать о деградации производительности. Если вовремя заметить тренд, можно предотвратить простой.
Вторая функция — коммуникация. Метрики дают общий язык между бизнесом и IT. Когда директор говорит «SLA 99,9%», техдиректор понимает, сколько минут простоя допустимо. Когда руководитель видит метрику стоимости владения системой, он может сравнивать эффективность разных решений. Без этих цифр переговоры превращаются в обмен эмоциями.
Третья — мотивация. Если команда разработки знает, что её оценивают по времени доставки фич и частоте сбоев, она начинает работать иначе. Но важно, чтобы метрики были справедливыми и не провоцировали «охоту на ведьм». Иначе вместо улучшения процессов вы получите скрытие проблем.
Как выбрать метрики: от целей до показателей
Выбор метрик начинается не с инструментов и не с готовых шаблонов, а с вопроса: «Какие бизнес-цели мы преследуем?». Технологические метрики должны быть производными от стратегии, а не самоцелью. Если компания стремится к быстрому масштабированию, нужны одни показатели; если к снижению издержек — другие.
Связка метрик с бизнес-целями
Правило простое: каждая метрика должна отвечать на вопрос, как технология помогает достичь цели. Например, цель «сократить время вывода продукта на рынок» требует метрики Time to Market. Цель «повысить лояльность клиентов» — метрики доступности сервисов и времени решения инцидентов. Цель «оптимизировать бюджет» — показателей стоимости владения и удельных затрат.
Связка «бизнес-цель → технологическая метрика» превращает IT из затратного подразделения в источник конкурентного преимущества.
Gartner выделяет семь характеристик метрик, которые действительно влияют на принятие бизнес-решений и связаны с IT: чёткая причинно-следственная связь с бизнес-результатом (например, простои в терминах недополученной продукции); опережающий характер (предсказательная ценность выше, чем историческая); учёт уникальности организации (нельзя копировать чужие метрики); нацеленность на конкретную аудиторию и её решения; отражение языка бизнеса, а не технического жаргона; измеримость и прозрачность; возможность регулярного пересмотра. Эти критерии помогают отсеивать показатели, которые лишь создают видимость контроля.
От чего зависит выбор метрик
Выбор зависит от трёх факторов: зрелости компании, специфики отрасли и доступности данных. Молодая компания на раннем этапе может фокусироваться на скорости разработки и гибкости. Зрелый бизнес с большими системами — на надёжности и безопасности данных. Для e-commerce критичны доступность сайта и время загрузки страниц, для производственного предприятия — бесперебойная работа ERP и автоматизированных линий.
Также важно учитывать, какие данные реально можно собирать. Некоторые метрики, например удовлетворённость пользователей, требуют регулярных опросов. Другие, как доля ручных операций, могут вычисляться по логам автоматизации. Если данных нет, метрику придётся внедрять поэтапно.
Для оценки зрелости IT-подразделения полезны бенчмарки: один IT-специалист на 40–60 сотрудников компании, а доля IT-затрат в обороте обычно составляет 2,7–6,5% (Плата) для компаний, чей бизнес не связан с технологиями. На высоких уровнях зрелости (по модели CobiT) оправдано оценивать возврат инвестиций (ROI) от IT-проектов.
Дополнительно при выборе метрик полезно ориентироваться на приоритеты: если важна скорость и гибкость, фокус на Time to Market, Lead Time, Cycle Time, Release Frequency, MTTR; если стабильность — на Technical Debt, Critical Bugs, Critical Vulnerabilities, количестве новых тест-кейсов; если конечный результат — на пропускной способности (Throughput), Velocity, прогнозируемости. Комбинируя эти группы, вы получаете сбалансированную картину.
Полезно также различать показатели в зависимости от стадии развития ИТ-функции. Модель RGT (run, grow, transform — «запуск, развитие, трансформация») предлагает разделять метрики на три уровня: на этапе запуска важен контроль за стабильностью (доступность, инциденты), на этапе развития — обновления и дополнительный функционал (частота релизов, Time to Market), на этапе трансформации — совершенно новые бизнес- или технологические возможности (инновации, выход на новые рынки). Такой подход помогает ИТ-директору сбалансировать систему показателей и не смешивать операционные и стратегические метрики CIO.
Как определить минимальный набор метрик
Начните с трёх-четырёх показателей, критичных для вашего бизнеса. Для большинства компаний это
- Доступность ключевых сервисов (uptime).
- Среднее время восстановления после сбоя (MTTR).
- Время отклика системы (latency).
- Удовлетворённость пользователей IT-сервисами.
Этого достаточно, чтобы понять состояние IT-функции. Постепенно добавляйте новые метрики, но только если они помогут принять конкретное решение. Если вы не знаете, что будете делать с числом, — не вводите его.
Для небольшой компании, у которой нет выделенного IT-отдела, набор может быть ещё короче: доступность сайта или CRM, время реакции на заявки клиентов, стоимость поддержки в расчёте на одного пользователя. Не гонитесь за полнотой — начните с малого и уточняйте.
Типичные зоны роста в IT-подразделениях
При оценке эффективности IT-функции важно знать, где чаще всего скрываются проблемы. Практика показывает, что типичные предпосылки будущих сбоев — это снижение производительности из-за неэффективных внутренних процессов (длительные циклы разработки, большое количество инцидентов), отсутствие метрик и объективных ориентиров, высокий уровень затрат с регулярным превышением бюджета, непрозрачность формирования совокупной стоимости владения для бизнеса, а также несоответствие численности сотрудников реальным потребностям. Отдельная зона риска — недостаточная автоматизация IT-процессов, из-за которой на выполнение задач уходит больше времени и человеческих ресурсов, а также неопределённые цели и направления развития IT, ведущие к хаотичному развитию GlobalCIO|DigitalExperts.
Для описания и оценки зрелости IT-процессов в российских компаниях обычно используется библиотека ITIL. Процессы из корпоративного каталога, разработанного на её основе, оцениваются по пятибалльной шкале, где каждый балл соответствует определённому описанию текущего состояния. Ключевые показатели при этом делятся на финансовые и качественные: доля IT-затрат в общих затратах компании, сумма затрат на одного пользователя, доля IT-специалистов к общей численности, удовлетворённость качеством услуг и среднегодовая текучесть IT-персонала.
Важнейшие технологические метрики для контроля IT-функции
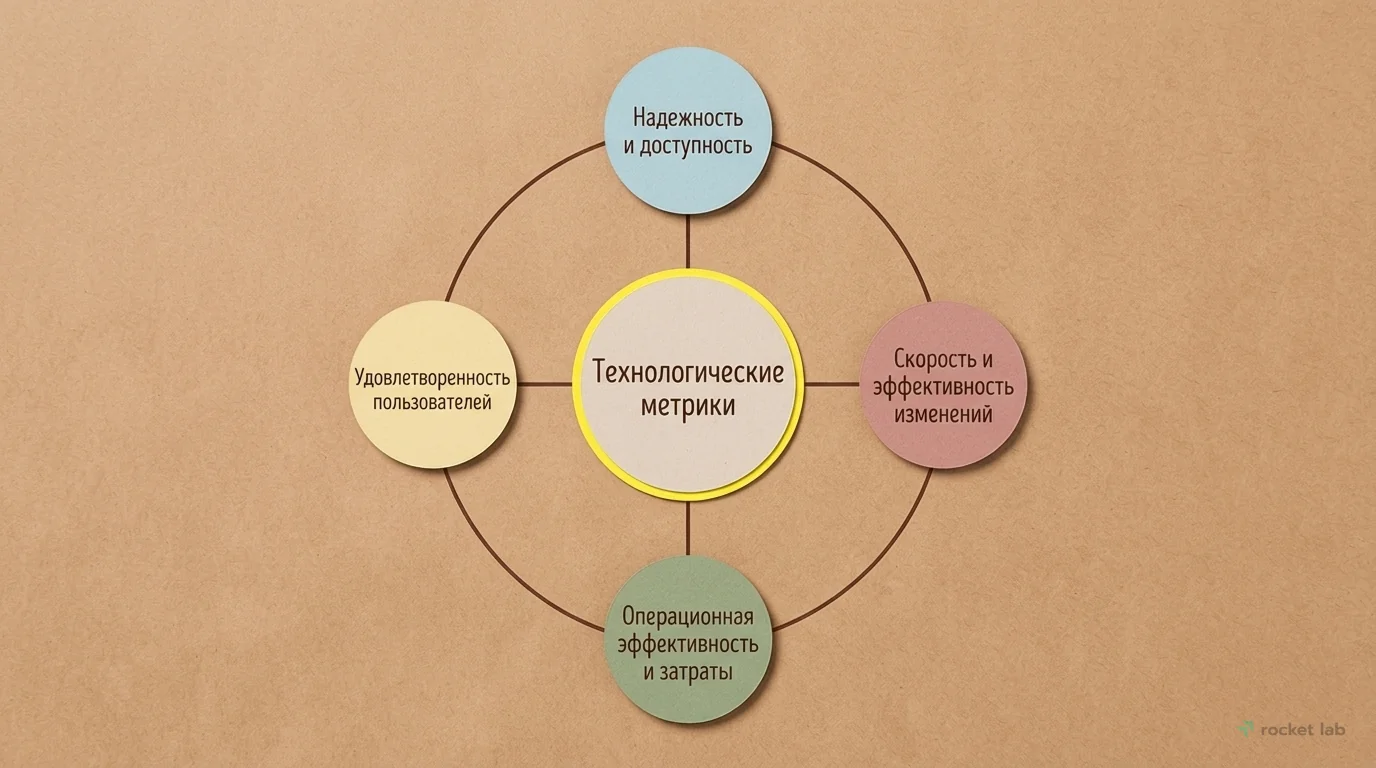
Теперь перейдём к конкретным показателям. Ниже — группа метрик, которые помогают контролировать ключевые аспекты работы IT: надёжность, скорость, эффективность и удовлетворённость. Это основные показатели эффективности IT, которые стоит внедрять в первую очередь.
Ключевые области контроля IT-функции
Надёжность и доступность систем
Надёжность системы — это способность выполнять свои функции без сбоев в течение заданного времени. Самая популярная метрика — доступность (availability), обычно выражается в процентах: 99,9%, 99,99%. Она показывает долю времени, когда сервис работал и был доступен пользователям.
Uptime и среднее время восстановления (MTTR)
Uptime — это время, в течение которого система работала корректно. Его принято считать в процентах к общему времени. Например, при доступности 99,5% (allcontract.ru · documents · c) в год допустимо около 43 часов простоя. Для многих B2B-сервисов этого недостаточно — нужен уровень 99,9% и выше.
MTTR (Mean Time To Repair) — среднее время восстановления после сбоя. Чем ниже этот показатель, тем быстрее компания возвращается к работе. MTTR включает время обнаружения проблемы, диагностику и непосредственно устранение. Для критичных систем нормальным считается MTTR до 1 часа. Если у вас MTTR измеряется сутками — это повод пересмотреть процессы.
Дополнительно к MTTR стоит отслеживать среднее время между сбоями (MTBF) — чем оно выше, тем стабильнее система. Для бизнеса также важны метрики максимального разового простоя и количества нарушений за период: длительный простой может нанести больший ущерб, чем частые короткие прерывания. Например, если все допустимые 9 часов простоя в год (при доступности 99,9%) случатся разом, это критично, а если разбить их на 15-минутные отрезки — потери будут меньше.
Важный нюанс: процент доступности не всегда точно отражает влияние на бизнес. ITIL вводит для этого дополнительные показатели — MTRS (Mean Time to Restore Service) и MTBF. Кроме того, в зависимости от специфики услуги полезно отслеживать «Минимальную продолжительность работы без нарушений» — она показывает, как часто пользователи сталкиваются с прерываниями, даже если суммарное время простоев невелико. Бизнес несёт потери не только от длительности, но и от частоты сбоев, особенно если процессы требуют перезапуска вычислений Cleverics.
Ещё одна полезная метрика — уровень сбоев (Crash Rate) — процент сессий взаимодействия пользователя с приложением, которые завершились ошибкой. Она дополняет uptime, показывая долю неудачных обращений, а не только общую доступность. Низкий Crash Rate (менее 1–2%) свидетельствует о стабильности продукта, высокий — о проблемах в коде или инфраструктуре.
Частота и повторяемость инцидентов по сервисам
Просто считать количество инцидентов мало. Важно видеть динамику и повторяемость. Если один и тот же сбой случается раз в месяц, это сигнал о системной проблеме. Метрика «частота повторяющихся инцидентов» помогает выявлять такие паттерны и устранять корневые причины.

Целевая точка и время восстановления (RPO, RTO)
Эти две метрики определяют стратегию резервного копирования и аварийного восстановления. RPO (Recovery Point Objective) — максимально допустимый объём потерянных данных. RTO (Recovery Time Objective) — максимально допустимое время восстановления после катастрофы. Они тесно связаны с бюджетом IT: чем меньше RPO и RTO, тем дороже инфраструктура.
Сравнение RPO и RTO для различных систем
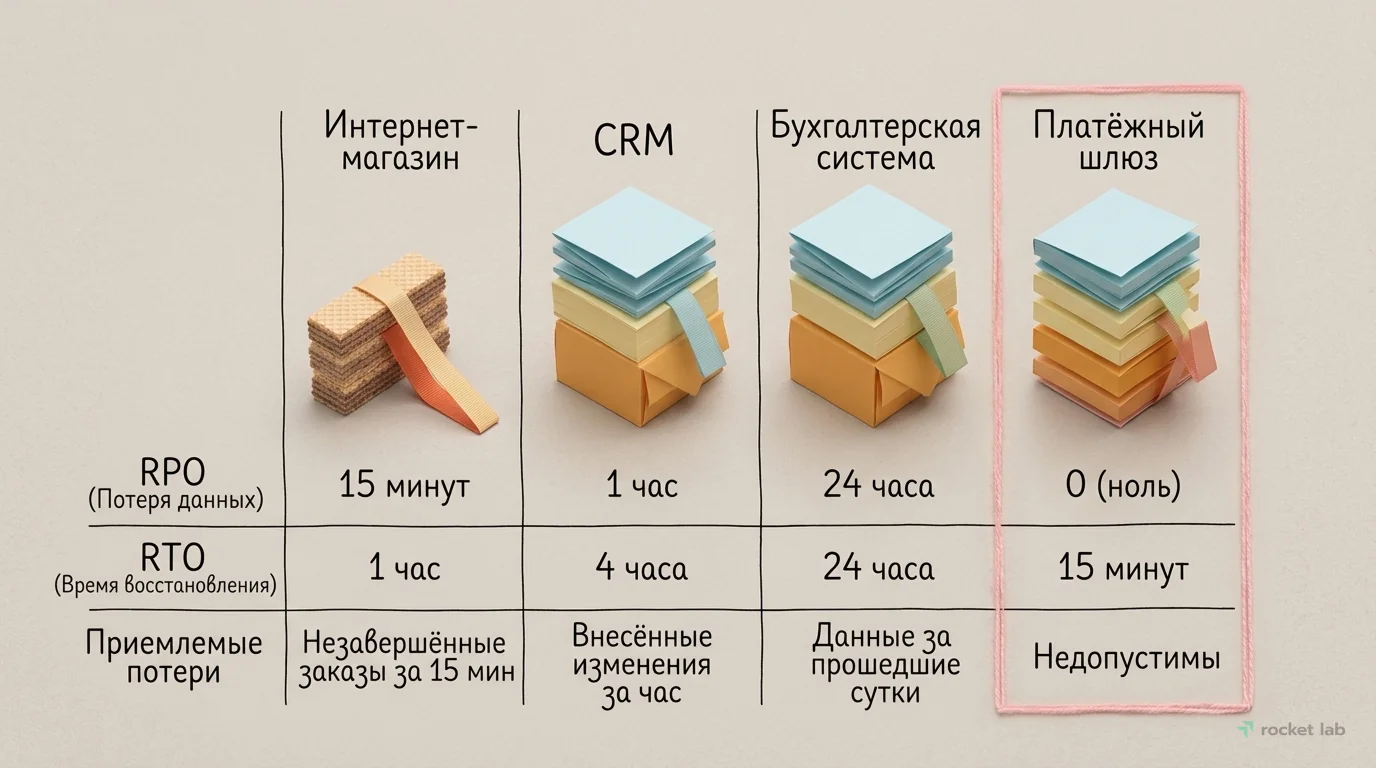
Вот как выглядят типичные значения для разных классов систем:
| Система | RPO | RTO | Приемлемые потери |
|---|---|---|---|
| Интернет-магазин | 15 минут | 1 час | Незавершённые заказы за последние 15 минут |
| CRM | 1 час | 4 часа | Внесённые изменения за час |
| Бухгалтерская система | 24 часа | 24 часа | Данные за прошедшие сутки |
| Платёжный шлюз | 0 (ноль) | 15 минут | Недопустимы |
При выборе значений RPO и RTO важно учитывать максимальный объём информации, который можно потерять без критических последствий, отраслевые особенности (например, регулярное обновление данных в медицинских или финансовых операциях), место хранения данных (локально или в облаке), а также стоимость внедрения системы аварийного восстановления и её соответствие требованиям к потерям и доступности.
Скорость и эффективность изменений
Скорость изменений определяет, насколько быстро компания реагирует на требования рынка. Медленная разработка и долгие релизы — распространённая причина потери клиентов.
Time to Market — от идеи до пользователя
Time to Market (TTM) — это время от момента возникновения идеи до момента, когда пользователь получает новую функцию или продукт. Короткий TTM позволяет быстрее тестировать гипотезы и обгонять конкурентов. Для цифровых продуктов нормой считается TTM от 1 до 4 недель. Если он растягивается на месяцы, бизнес несёт упущенную выгоду.
Согласно исследованию McKinsey, компании, способные быстро выпускать обновления, демонстрируют рост выручки на 35% выше среднего по рынку, а их прибыльность увеличивается на 10% McKinsey.
Lead Time и Cycle Time — метрики скорости
Lead Time — это полное время от запроса до его выполнения, включая ожидание в очереди. Cycle Time — время непосредственной работы над задачей. Разница между ними показывает количество «мёртвого времени»: ожидания, согласования, простои.
Например, если Cycle Time разработчика — 2 дня, а Lead Time — 10 дней, значит, 8 дней задача лежит без движения. Сокращение Lead Time достигается не ускорением работы, а устранением простоев: настройкой приоритетов, уменьшением числа одновременных задач, автоматизацией передач между отделами.
При анализе Cycle Time полезно смотреть не только среднее значение, но и медиану и 85-й перцентиль. Например, если половина задач закрывается за 2 дня, а 85% — не дольше чем за 5 дней, это говорит о стабильности процесса. Рост Cycle Time — сигнал о появлении узкого места: ревью, ожидание тестов или раздутый WIP. Многие команды признают Cycle Time самой честной метрикой, поскольку она оценивает работу всей системы, а не отдельных сотрудников, и не провоцирует «игру под цифры». Важно договориться, какие статусы считаются началом и концом работы: обычно это переход из «In Progress» в «Done» (или «В продакшене»). Ожидание в бэклоге — это уже Lead Time, и оно не должно портить картину по скорости выполнения.
Для визуализации потока задач полезна кумулятивная диаграмма потока (Cumulative Flow Diagram). Она показывает, сколько задач находится на каждом этапе — от бэклога до done. Если линии на графике расходятся, значит, на каком-то этапе задачи поступают быстрее, чем обрабатываются. Это сигнал, что нужно пересмотреть распределение нагрузки или процесс ревью и тестирования.
Ещё одна метрика, дополняющая пару Lead/Cycle Time, — Flow Efficiency. Она показывает долю «активного» времени в общем времени прохождения задачи: Flow Efficiency = (время активной работы) / (общее Lead Time) × 100%. Если Flow Efficiency низкая (например, ниже 20%), значит, основное время задачи тратят в ожидании, а не в работе. Для Kanban-команд также важна метрика WIP (Work In Progress) — количество задач, находящихся в работе одновременно. Раздутый WIP — главная причина роста Cycle Time и снижения предсказуемости.
Капасити (Capacity) — оценка будущей загрузки
Капасити (capacity) — это оценка максимального объёма будущих результатов, которая основывается на анализе общего количества времени в конкретном спринте разработки проекта. Формула capacity фокусируется на ресурсах и учитывает возможные форс-мажоры, например дополнительные обязанности вне заданий разработчика. Рекомендуется использовать и velocity, и capacity для качественной оценки производительности: velocity показывает фактическую скорость, а capacity — потенциальную загрузку команды с учётом отпусков, больничных и прочих потерь времени.
Частота релизов и доля неудачных изменений
Частота релизов показывает, насколько часто команда выкатывает изменения в продакшн. Чем чаще релизы, тем меньше объём каждого из них и ниже риск. Доля неудачных изменений (change failure rate) — это процент релизов, которые привели к сбоям или откатам. В зрелых командах этот показатель держится на уровне 5–15%.
Современная практика — непрерывная поставка (continuous delivery), когда релизы происходят несколько раз в день. Для небольшой компании это может быть избыточно, но стремление к еженедельным обновлениям — разумный ориентир.
Операционная эффективность и затраты
Технологические метрики не могут игнорировать финансовую сторону. IT — это инвестиция, и её нужно оценивать.
Автоматизация и доля ручных операций
Доля ручных операций показывает, какая часть работы выполняется без участия человека. Чем ниже этот показатель, тем меньше ошибок и выше скорость. Например, если деплой кода происходит вручную, каждый раз возможна человеческая ошибка. Автоматизация деплоя снижает риск и освобождает разработчиков.
В одном из наших проектов — B2B-сервисе по ремонту техники — автоматизация выгрузки отчётов сократила время их подготовки с 3 часов до 20 минут в неделю. Мелочь, но в масштабе года это экономия около 150 человеко-часов. Плюс сотрудники перестали допускать ошибки при копировании данных.
Удельные затраты на IT-инфраструктуру
Стоимость владения IT-инфраструктурой (TCO) — важный показатель для бюджетирования. Он включает затраты на оборудование, лицензии, персонал, электроэнергию, амортизацию. Удельные затраты — это TCO в пересчёте на одного пользователя, на одну операцию или на рубль выручки.
Сравнение удельных затрат между периодами помогает оценить эффективность цифровой трансформации. Например, если затраты на IT растут медленнее, чем выручка, — значит, масштабирование происходит эффективно. Если наоборот, стоит пересмотреть архитектуру или поставщиков.
При расчёте TCO важно разделять прямые и косвенные затраты. Прямые (бюджетные) расходы включают капитальные затраты на аппаратное и программное обеспечение, техническую поддержку, разработку прикладного ПО внутренними силами, управление и администрирование сетей. Косвенные расходы делятся на две группы: потери от неработоспособности системы (простои, перерывы в работе пользователей) и непроизводительные усилия конечных пользователей, которые вынуждены самостоятельно решать проблемы из-за ненадлежащей поддержки. Первая группа может быть оценена через производственные потери, вторая — через полевые и статистические исследования. Косвенные расходы находятся за рамками бюджетов на IT, но часто именно они составляют существенную долю совокупной стоимости владения itWeek.
Полезной метрикой является здоровье бэклога (Backlog Health) — количество и «возраст» невыполненных задач в очереди технической поддержки. Растущий «возраст» задач указывает на перегрузку команды и снижение качества обслуживания.
Ещё одна полезная метрика — On-Time Delivery (процент задач, выполненных в срок). Она показывает дисциплину планирования и выполнения обязательств. Идеальный показатель — 90–100% Sky.pro.
Дополнительно стоит отслеживать отклонение бюджета (Budget Variance) — разницу между запланированными и фактическими затратами на проект или IT-функцию. Оно помогает выявлять перерасход на ранних стадиях и корректировать планы. Если отклонение регулярно превышает 10–15%, это сигнал о проблемах с оценкой трудозатрат или управлением требованиями.
Оценка эффективности ИТ-инвестиций
Для оценки эффективности ИТ-проектов применяются три группы методов: финансовые (количественные), качественные и вероятностные. Финансовые методы основаны на дисконтировании денежных потоков и используют такие инструменты, как чистый дисконтированный доход (NPV), внутренняя норма доходности (IRR) и срок окупаемости. В рамках финансового подхода возможны два варианта расчёта: оценка прироста выгоды (разница между увеличением доходов и расходами на разработку и эксплуатацию) и оценка чистого сокращения издержек (разница между ожидаемым сокращением затрат и расходами на внедрение). Оба подхода вместе дают более полную картину.
Качественные методы дополняют количественные расчёты субъективными оценками ценности персонала и процессов. Среди них — метод информационной экономики и IT Scorecard, которые базируются на согласовании целей, приоритетов и показателей. Вероятностные методы используют статистические модели для оценки рисков — например, прикладная информационная экономика (Applied Information Economics) и метод справедливой цены опционов (Real Options Valuation). Выбор конкретного метода зависит от специфики проекта и доступности данных Science Forum.
Удовлетворённость пользователей IT-сервисами
Как бы хорошо ни работали системы, главный судья — пользователь. Метрика удовлетворённости обычно измеряется опросами (CSAT, NPS) или косвенными показателями: количество жалоб, время ожидания ответа, частота обращений в поддержку.
Важно измерять удовлетворённость не только внешних клиентов, но и сотрудников, которые используют внутренние системы. Если бухгалтерия постоянно ругает CRM, это сигнал к доработке. Игнорирование таких сигналов приводит к тому, что люди начинают использовать Excel в обход системы, создавая новые проблемы.
Дополнительно к CSAT и NPS стоит обратить внимание на CES (Customer Effort Score) — оценку лёгкости взаимодействия с сервисом. Эта метрика показывает, насколько просто клиенту решить свою проблему, и особенно полезна для команд поддержки и сервиса. Низкий CES часто предшествует падению удержания клиентов.
Для продуктовых команд также полезны метрики активности пользователей: DAU/MAU (количество уникальных активных пользователей за день/месяц) и коэффициент удержания (Retention). DAU/MAU показывает вовлечённость аудитории, а Retention — насколько продукт удерживает клиентов после первого использования. Эти показатели помогают оценить, насколько технологические изменения действительно приносят пользу бизнесу.
Метрики продуктивности IT-команд
Оценка работы команды — самая деликатная тема. Здесь легко скатиться к «палочной» системе, когда метрики ради метрик. Задача руководителя — выбрать показатели, которые стимулируют правильное поведение, а не выжимают из людей последние силы.
Современные фреймворки оценки IT-команд
Для комплексной оценки продуктивности IT-команд сегодня используются признанные мировые фреймворки. Методология DORA (DevOps Research and Assessment) выделяет четыре ключевые метрики: частоту развертываний, время выполнения изменений, среднее время восстановления (MTTR) и долю неудачных изменений. Этот подход считается «золотым стандартом» для DevOps-команд DORA.
Фреймворк SPACE, разработанный GitHub и Microsoft Research, дополняет DORA пятью измерениями: удовлетворённость и благополучие, производительность, активность, коммуникация и сотрудничество, эффективность и поток. Он позволяет учитывать не только скорость, но и человеческий фактор SPACE.
Подход DevEx (Developer Experience) фокусируется на опыте разработчиков: скорости взаимодействия с инструментами, качестве среды и отсутствии блокеров. Методология GSM (Goals-Signals-Metrics) помогает выстраивать метрики исходя из бизнес-целей, фокусируя внимание на действительно значимых показателях. А подход Performance-based metrics от McKinsey объединяет системный, командный и индивидуальный уровни, включая индекс скорости разработки и анализ вклада.
Согласно отчётам McKinsey, использование метрик снижает риск ошибок на 30–40% и повышает результативность работы команды.
Для распределённых команд, работающих удалённо или в гибридном формате, традиционные метрики требуют адаптации. Согласно исследованию, опубликованному в КиберЛенинке, онлайн-опрос более 2000 IT-специалистов показал, что для распределённых команд ключевое значение имеют показатели, связанные с качеством работы, прозрачностью процессов и эффективностью коммуникаций. В таких условиях важно дополнительно отслеживать синхронность взаимодействия, скорость ответов в каналах связи и долю задач, требующих уточнений из-за недопонимания КиберЛенинка.
Продуктивность и качество кода
Продуктивность разработки нельзя измерить одним числом. Нужен набор метрик, который учитывает и скорость, и качество.
Throughput — количество завершённых задач
Throughput показывает, сколько задач команда закрывает за определённый период (неделю, месяц). Это полезный показатель, но его нужно использовать с осторожностью. Если сравнивать throughput разных команд, можно спровоцировать «охоту за лёгкими задачами». Лучше смотреть динамику в одной команде и сопоставлять со сложностью задач.
Через Throughput удобно оценивать и Velocity — объём работы, который команда завершает за один спринт. Velocity измеряется в story points или условных единицах, принятых внутри команды. Считаются только завершённые задачи — те, что перешли в статус «Done». Если за спринт команда закрыла задачи на 21 story point, velocity = 21. Эта цифра помогает планировать будущие спринты и понимать, как изменения влияют на производительность — например, как сказался выход нового разработчика или внедрение новой системы. Важно помнить: velocity нельзя использовать для сравнения между командами — это внутренняя метрика, зависящая от того, как именно оцениваются story points. Рекомендуется усреднять Velocity по 3–5 спринтам, чтобы получать устойчивый прогноз.
Количество багов и скорость их исправления
Качество кода оценивается по количеству дефектов, обнаруженных после релиза, и времени их исправления. Метрика «количество багов на тысячу строк кода» — спорная, так как объём кода мало о чём говорит. Гораздо информативнее плотность дефектов на одну функцию или на один пользовательский сценарий.
Скорость исправления багов (bug resolution time) показывает, насколько оперативно команда реагирует на проблемы. Нормальным считается исправление критических багов в течение нескольких часов, некритических — в течение нескольких дней.
Дополнительные метрики качества, которые стоит отслеживать в динамике: количество reopen-задач (сигнал, что качество тестирования или ревью проседает), процент успешно пройденных тест-раундов QA, а также regression rate — время, затраченное на итерации регрессионного тестирования.
Доля кода, покрытого тестами
Покрытие тестами (test coverage) — это процент строк кода, которые проверяются автотестами. Высокое покрытие (70–80% (Регресс)) снижает риск регрессий и ускоряет разработку, потому что разработчики могут спокойно менять код без страха что-то сломать. Однако 100% покрытие не гарантирует отсутствия багов — важно тестировать сценарии, а не просто строки.
Для оценки технического здоровья кодовой базы также используются метрики технического долга (tech debt): сумма согласованных единиц долга (story points или часов), измеряемая через «Debt Burn-down» по итогам итерации, а также rework rate — доля дефектов и переделок к объёму новых задач. Снижение обоих показателей — признак здорового процесса. Для автоматического анализа применяются инструменты вроде SonarQube, линтеры и статический анализ кода (SAST).
Эффективные часы разработки
Полезной метрикой для оценки реальной загрузки команды служит доля эффективных часов — времени, которое уходит непосредственно на решение задачи, без отвлечений, совещаний и «ворон». Соотнося эффективные часы с длиной итерации (например, 40-часовой рабочей неделей), можно выявить причины неэффективности: избыточные встречи, частые переключения контекста, ручные операции. Такой подход хорошо работает и для программистов, и для аналитиков, так как в их работе тоже есть задачи с измеримым результатом Habr.
Вовлечённость и комфорт сотрудников
Технологические метрики не должны игнорировать людей. Без мотивированной команды даже лучшие процессы не работают.
eNPS — индекс лояльности команды
eNPS (Employee Net Promoter Score) измеряется одним вопросом: «Готовы ли вы рекомендовать нашу компанию как место работы?» Оценка от 0 до 10. Ответы 9–10 считаются «промоутерами», 7–8 — «нейтралами», 0–6 — «критиками». Показатель вычисляется как разница процентов промоутеров и критиков. Он может быть отрицательным, что является тревожным сигналом.
eNPS полезен, потому что он коррелирует с текучестью кадров и продуктивностью. Команды с высоким eNPS реже увольняются и лучше справляются с задачами.
Опросы и обратная связь
Раз в квартал стоит проводить короткие опросы о комфорте работы, загруженности, взаимодействии с другими отделами. Это не обязательно eNPS — можно использовать открытые вопросы. Главное — собирать ответы анонимно и показывать, что на их основе принимаются решения. Иначе обратная связь превращается в пустую формальность.
Эффективны пульсовые опросы (pulse surveys) с 2–5 вопросами, которые проводятся раз в 2–4 недели. Вопросы вроде «Чувствую ли я, что делаю важную работу?», «Есть ли у меня всё для выполнения задач?», «Чувствую ли я поддержку коллег?» показывают эмоциональную динамику и позволяют реагировать до того, как проблемы станут критичными. Регулярная самооценка команды раз в 2–4 недели также полезна: оцениваются мотивация, процессы, цели, взаимопомощь, удовлетворённость. Результаты можно фиксировать в виде «светофора» (зелёный — всё хорошо, жёлтый — требует внимания, красный — есть проблема).
Косвенные метрики вовлечённости: participation rate (доля сотрудников, активно создающих или ревьюящих pull request-ы), участие в обсуждениях и ретроспективах. Если вовлечённость падает, это может говорить не о лени, а о потере смысла или нехватке прозрачности в процессе.
Время на профессиональное развитие
Современный IT развивается быстро. Метрика «часы на обучение на одного сотрудника» помогает понять, инвестирует ли компания в рост команды. Рекомендуемый минимум — 4 часа в неделю на человека. Это не только повышает квалификацию, но и снижает выгорание, давая людям возможность отвлечься от рутины.
Баланс метрик и человеческого фактора
Важно понимать: метрики — это инструмент, а не цель. Никакой KPI не заменит здравого смысла. Если команда из-за погони за цифрами перестаёт общаться с пользователями, страдает продукт. Если разработчики боятся выкатывать релизы из-за метрики «доля неудачных изменений», они начинают блокировать изменения.
Внедряя метрики для оценки IT-отдела, помните: они должны помогать людям делать работу лучше, а не искать виноватых.
Как внедрить систему метрик безболезненно
Внедрение метрик часто встречает сопротивление. Сотрудники боятся, что их начнут наказывать за цифры. Руководители опасаются, что метрики не отразят реальную картину. Чтобы процесс прошёл гладко, следуйте пошаговому плану.
Пошаговый план внедрения
- Определите цели. Сформулируйте, какие решения вы будете принимать на основе метрик. Запишите их на бумаге.
- Выберите 5–7 ключевых показателей. Не больше. Они должны покрывать надёжность, скорость, стоимость и удовлетворённость.
- Наладьте сбор данных. Убедитесь, что данные автоматически попадают в удобное хранилище: логи, дашборды, CRM.
- Обсудите с командой. Объясните, зачем нужны метрики и как они будут использоваться. Снимите страхи.
- Запустите пилотный период. Собирайте данные 1–2 месяца, не делая резких выводов. Откалибруйте целевые значения.
- Внедрите регулярные отчёты. Определите периодичность (неделя/месяц) и ответственных.
- Пересматривайте метрики. Раз в квартал проверяйте, актуальны ли показатели. Убирайте лишние, добавляйте новые.
При внедрении KPI для отдельных должностей важно соблюдать несколько практических правил. Начинайте не со всех 100% персонала, а с 20% должностей, которые обеспечивают ~80% результатов бизнеса — как правило, это топ-менеджеры и сотрудники ключевых бизнес-процессов. Для каждой должности выбирайте не более 3 KPI — слишком большой набор усложняет фокус и учёт. Доля переменной части зарплаты, зависящей от KPI, должна составлять не менее 20% — меньший процент слабо мотивирует; верхний предел обычно 50–80% для отделов, напрямую влияющих на выручку. Если показателей несколько, распределите веса — вклад каждого KPI в общий бонус (в сумме 100%). Определите пороговые значения: для дискретных KPI («выполнено/не выполнено») 100% выполнения даёт полный бонус, ниже плана — 0%; для количественных — введите градации, например 80% выполнения даёт 50% премии, а перевыполнение >120% не увеличивает выплату сверх потолка. Все правила оформите в виде понятного регламента, избегая копирования чужих шаблонов A2 Team.
Типичные ошибки при настройке контроля
Самая распространённая ошибка — попытка оцифровать всё сразу. Нельзя объять необъятное: команда захлебнётся в данных. Вторая ошибка — использование метрик для наказания. Если человек допустил ошибку, разберите её в обучающем ключе, а не в репрессивном.
Третья ошибка — копирование чужих метрик без адаптации. То, что работает в крупном банке, может быть бесполезно для небольшого интернет-магазина. Метрики для небольшой компании должны быть простыми и связанными с деньгами.
Наконец, не забывайте про ложные корреляции. Например, рост числа инцидентов может быть вызван расширением функциональности, а не деградацией системы. Всегда интерпретируйте цифры в контексте.
Помните также, что разные уровни управления требуют разных метрик. Команде нужны операционные показатели, на которые она может влиять напрямую (время восстановления, частота релизов), а руководству — агрегированные бизнес-метрики (стоимость владения, влияние на выручку). Использование одного набора для всех создаёт путаницу и снижает доверие.
Важно не измерять людей через «количество строк кода», «время за клавиатурой» или «экранное время» — такие метрики стимулируют фальшивую активность и мешают фокусу на ценности. Сбалансированная система метрик — это «рентген» всей системы, а не инструмент давления на отдельных исполнителей.
Инструменты для автоматизации сбора данных
Ручной сбор метрик — удел компаний на раннем этапе. Когда систем становится больше, нужна автоматизация.
Вот базовый набор инструментов
- Мониторинг инфраструктуры: Grafana, Zabbix — отслеживание доступности, нагрузки, времени отклика.
- Мониторинг ошибок: Sentry — сбор информации о сбоях в приложениях.
- CI/CD и аналитика релизов: GitLab — пайплайны, частота релизов, доля неудачных изменений.
- Управление задачами: Яндекс Трекер — для учёта задач, lead time, cycle time.
- BI-системы: Yandex DataLens — построение дашбордов и связь метрик с бизнес-показателями.
Для небольшой компании можно начать с бесплатных тарифов Grafana и Yandex DataLens. Для управления IT-бюджетом полезны сервисы учёта затрат, например, Битрикс24 или AmoCRM — они позволяют связать технические метрики с воронкой продаж.
Для анализа качества кода и технического долга используются SonarQube, линтеры и статический анализ кода (SAST), а для проверки безопасности зависимостей — npm audit, pip-audit и аналогичные инструменты.
Сквозная аналитика как связующее звено между IT и бизнесом
Для бизнеса, который продаёт через сайт или digital-каналы, важно выйти за рамки чисто технических метрик и увидеть, как технологии влияют на деньги. Здесь ключевую роль играет сквозная аналитика — подход, который связывает все источники данных в единую картину: источник трафика → сайт → лид → менеджер → продажа → LTV. Без неё невозможно посчитать реальный ROI каналов — только количество заявок.
Минимальная связка для сквозной аналитики выглядит так: Яндекс Метрика (основа для российского рынка) + Google Analytics 4 (обязательно при работе с Google Ads) + коллтрекинг (CallTouch, CoMagic или UIS) для отслеживания звонков + CRM (Битрикс24 или AmoCRM) для отслеживания заявок до сделки. Всё это объединяется в дашборде, который руководитель смотрит раз в неделю.
Принцип отбора метрик для такого дашборда простой: каждая цифра должна проходить проверку «Какое решение я приму на основе этой цифры?». Если ответа нет — метрика не нужна. Метрики делятся на три уровня: финансовые (выручка, прибыль, ROI, CAC, LTV), операционные (конверсия, лиды, заявки, продажи) и технические (трафик, CTR, время на сайте). Технические метрики — это следствие, а не цель.
Ключевые формулы для руководителя
- CAC (стоимость привлечения клиента) = Затраты на маркетинг / Количество новых клиентов. Главная метрика для оценки эффективности воронки.
- LTV (пожизненная ценность клиента) = Средний чек × Частота покупок × Срок удержания клиента. Показатель здоровья бизнеса: LTV в 3+ раза выше CAC обычно означает отличный бизнес или недоинвестирование в рост.
- ROAS (окупаемость рекламы) = Выручка от рекламы / Затраты на рекламу. Значение 3+ обычно означает прибыльную рекламу (зависит от маржинальности).
Важная практика: считайте конверсию отдельно для каждого канала, типа страницы и сегмента аудитории. Усреднённая конверсия по сайту — бесполезная метрика, скрывающая правду. Например, конверсия с органики 4,5%, с рекламы 1,8%, с прямых заходов 6% — это разные истории, и решения по ним нужны разные.
Что запомнить
- Определите технологические метрики для бизнеса, исходя из стратегических целей, а не из модных трендов.
- Используйте не более 5–7 ключевых показателей одновременно.
- Сочетайте метрики надёжности (uptime, MTTR), скорости (TTM, Lead Time) и эффективности (TCO, удовлетворённость).
- Внедряйте метрики постепенно, вовлекая команду и объясняя смысл.
- Автоматизируйте сбор данных через мониторинг и BI-системы.
- Регулярно пересматривайте набор метрик и удаляйте неинформативные.
- Для оценки зрелости процессов используйте библиотеку ITIL и сравнивайте показатели с бенчмарками по аналогичным компаниям на рынке.
- Подключайте сквозную аналитику, чтобы связать технические метрики с финансовыми результатами бизнеса.
- Для распределённых команд дополнительно отслеживайте прозрачность процессов и эффективность коммуникаций.
- Проверяйте каждую метрику по критериям Gartner: связь с бизнес-результатом, опережающий характер, учёт специфики организации.
- Разделяйте метрики по стадиям развития ИТ-функции (модель RGT: запуск, развитие, трансформация).
- При внедрении KPI для должностей выбирайте не более 3 показателей на роль, задавайте веса и пороговые значения.
Частые вопросы (FAQ)
Какие метрики критически важны для руководителя?
Для руководителя важны четыре группы: доступность сервисов (uptime), время восстановления (MTTR), стоимость владения IT и удовлетворённость пользователей. Эти метрики показывают, работает ли технологическая инфраструктура надёжно, оправдывает ли она затраты и приносит ли пользу бизнесу.
Как часто нужно пересматривать метрики?
Полный пересмотр набора метрик рекомендуется проводить раз в квартал. Внеплановый пересмотр нужен при смене стратегии, запуске нового продукта или значительном изменении инфраструктуры. Важно следить, чтобы метрики оставались актуальными, а не превращались в ритуал.
Можно ли сравнивать метрики разных команд?
Сравнивать напрямую можно только при одинаковых условиях: схожие задачи, уровень зрелости и инструменты. В противном случае сравнение будет некорректным. Лучше анализировать динамику внутри команды и сравнивать её с собственными предыдущими периодами.
Как избежать «охоты на ведьм» при внедрении метрик?
Объясните команде, что метрики вводятся для выявления проблем в процессах, а не для поиска виноватых. Используйте данные для коллективного разбора и улучшения. Не привязывайте премии жёстко к индивидуальным показателям, особенно на старте внедрения.
Какие инструменты помогут в сборе и анализе метрик?
Для сбора данных используйте системы мониторинга (Grafana, Zabbix), для управления задачами — Яндекс Трекер, для визуализации — Yandex DataLens. Для малого бизнеса подойдут бесплатные версии этих инструментов, а также встроенная аналитика в CRM-системах.
Что такое сквозная аналитика и кому она нужна?
Сквозная аналитика связывает данные о трафике, лидах, звонках, продажах в единую систему. Минимальная связка: Яндекс Метрика + GA4 + коллтрекинг + CRM. Без неё невозможно посчитать реальный ROI каналов — только количество заявок. Нужна любому бизнесу с бюджетом на digital от 100 000 ₽ в месяц или 30+ заявок в месяц. Настройка занимает 2–4 недели и окупается обычно за 1–3 месяца за счёт перераспределения бюджета на эффективные каналы.