

A/B-тестирование — это метод сравнения двух версий страницы или элемента, при котором пользователи случайным образом разделяются на контрольную и экспериментальную группы. Проблемы A/B тестирования возникают на каждом этапе: от формулировки гипотезы до интерпретации результатов. Без правильной методологии эксперименты дают ложные выводы, а команда тратит недели на внедрение изменений, которые не работают.
Почему A/B-тесты часто дают ложные результаты

Фальстарт: ошибка нетерпеливых
Когда через два дня после запуска теста один вариант начинает выигрывать с разницей в 10%, очень трудно удержаться от соблазна остановить эксперимент. Команда видит «очевидную» победу и спешит внедрить изменение.
На самом деле первые дни теста — период максимального шума. Пользователи ведут себя по-разному в будни и выходные, а случайные колебания могут создать ложный эффект. Останавливая тест раньше срока, вы фиксируете случайность, а не закономерность.
По опыту нашей команды, преждевременная остановка теста увеличивает долю ложноположительных результатов минимум на 30% (A/B Testing Facebook Ads: Stat).
Статистический шум — это естественные колебания метрики, вызванные случайными факторами: действиями ботов, разным поведением новых и возвращающихся пользователей, сбоями в трекинге. При малых выборках шум легко принять за сигнал. Например, если конверсия в контрольной группе составляет 3%, а в экспериментальной — 4%, при размере выборки в 500 человек на группу разница не является статистически значимой. Чтобы отличить шум от реального эффекта, нужно дождаться накопления достаточного количества данных.
Обратная ошибка — искусственное продление теста. Если эксперимент не показал значимого результата к запланированному сроку, некоторые команды продлевают его в надежде «дорастить» значимость. Это ошибка: при идентичных группах разница в конверсиях может выходить за пределы зоны неразличимости, создавая ложные сигналы. С каждым дополнительным днём растёт вероятность случайных различий. Заранее определите нужный размер выборки и остановитесь ровно в этот момент.
Недостаточный объём выборки и низкая мощность
Ложноотрицательный результат — это ситуация, когда тест не показывает различий, хотя на самом деле они есть. Причина — недостаточный размер выборки. Статистическая мощность теста (вероятность обнаружить реальный эффект) падает, и вы рискуете отклонить удачную гипотезу. Например, если реальный прирост конверсии составляет 5%, а выборка рассчитана на обнаружение 10%, тест почти наверняка покажет «нет эффекта». В итоге вы упускаете улучшение, которое могло бы принести дополнительную выручку.
По оценкам практиков, до 50–70% A/B-тестов в компаниях начинаются с недостаточной статистической мощности. При этом если тест рассчитан на обнаружение крупного эффекта (например, +10%), а реальный прирост скромнее (+1–2%), он гарантированно останется незамеченным. Так вы начинаете системно отбрасывать реальные улучшения, что ломает продуктовую стратегию.
Ещё одно важное следствие низкой мощности — «проклятие победителя». Когда мощность теста мала, значимые результаты случаются редко, и возникают именно там, где случайный шум удачно совпал с направлением эффекта. Поэтому «победившие» тесты систематически завышают реальный эффект. Симуляция с истинным приростом +2 п.п. при 500 пользователях на группу (мощность около 17%) показывает: средний наблюдаемый прирост среди значимых тестов существенно завышен, а примерно 1 из 100 значимых результатов имеет обратный знак. Тест уверенно показывает падение там, где на самом деле рост.
Эти явления в статистике описывают как ошибки Type S (неверный знак эффекта) и Type M (завышение масштаба). При низкой мощности вероятность таких ошибок резко возрастает, поэтому при планировании теста стоит оценивать не только вероятность обнаружить эффект, но и риск перепутать его направление и масштаб (Gelman и Carlin).
Правильный вывод из слабого теста звучит не «эффекта нет», а «значимых различий не обнаружено; мощность против прироста в 2 п.п. была лишь 53%, так что отсутствие значимости — слабый аргумент». Также избегайте расчёта мощности постфактум по полученным данным: она полностью определяется p-value и не несёт новой информации. Вместо этого оценивайте доверительный интервал разницы и проверяйте, совместимы ли данные с практически значимым приростом.
Как рассчитать необходимый размер выборки
Размер выборки зависит от трёх параметров: текущей конверсии, минимального эффекта, который вы хотите обнаружить (MDE), и требуемой статистической значимости (обычно 95%). Чем меньше эффект, тем больше данных нужно. Для расчёта используют специальные калькуляторы, например, в сервисе Optimizely или VWO. Практическое правило: если конверсия 5%, а MDE — 1 процентный пункт, вам потребуется около 3000 пользователей на каждую группу.
Для более точного расчёта используйте стандартную формулу сравнения двух пропорций:
n = ((z_1-α/2 + z_1-β)^2 · 2 · p(1-p)) / (MDE^2)
где p — базовая конверсия, MDE — минимальный детектируемый эффект в абсолютных долях, z_1-α/2 = 1.96 при α = 0.05, z_1-β = 0.84 при мощности 80%. Пример: при базовой конверсии 4% и MDE = 0.5 п.п. нужно около 24 000 пользователей на группу. Обратите внимание: MDE стоит в знаменателе в квадрате. Уменьшив MDE вдвое, вы увеличите требуемую выборку в четыре раза. Именно поэтому MDE и мощность фиксируют до старта теста, а не после.
Учитывайте также компромисс между ошибками: при фиксированном размере выборки снижение alpha (реже ловить ложные эффекты) автоматически повышает beta (чаще пропускать реальные). Единственный честный способ уменьшить обе ошибки одновременно — увеличить размер выборки. И помните: мощность всегда привязана к конкретному размеру эффекта. Тест с мощностью 90% против прироста 5 п.п. может иметь мощность всего 15% против прироста 1 п.п. на тех же данных.
Также важно учитывать мощность теста (обычно 80–90%). Если вы собрали только 150 пользователей в каждую группу при требуемых 393, мощность теста падает ниже 40%. Шанс зафиксировать реальный эффект становится меньше, чем шанс его пропустить.
Ещё одно практическое правило, которое используют опытные аналитики: для каждого варианта нужно собрать минимум 100 конверсий (при высоком трафике — 250), прежде чем делать выводы. Если конверсий меньше, даже статистическая значимость не гарантирует достоверности результата.
Игнорирование внешних факторов и сезонности
Если вы запускаете A/B-тест в период распродаж или во время одновременной рекламной кампании, результаты будут искажены. Внешние факторы влияют на поведение пользователей одинаково для обеих групп, но если трафик из рекламы сильно отличается по качеству от органического, это может изменить конверсию. Например, в предновогодний период конверсия в интернет-магазинах растёт в 2–3 раза, и тест, проведённый в это время, покажет неэффективность изменений, которые на самом деле работают.
Самый простой способ — не проводить тесты в периоды явной сезонности. Если же тест длится несколько недель, включите в анализ сезонные коэффициенты или сравните результаты с аналогичным периодом прошлого года. Для этого нужно иметь достаточную историю данных. Альтернатива — использовать сегментацию аудитории: отдельно анализировать новых и возвращающихся пользователей, так как они по-разному реагируют на сезонные факторы.
Полезный приём — стратификация (блокировка): разбивайте пользователей на сегменты по значимым признакам (гео, канал трафика, тип устройства) и внутри каждого сегмента случайно распределяйте в группы. Это гарантирует, что в контрольную и экспериментальную группы попадут пользователи с одинаковыми характеристиками, и сезонные или внешние факторы не создадут перекос.
Когда группы изначально не равны
Sample Ratio Mismatch (SRM) — это ситуация, когда фактическое соотношение пользователей в контрольной и экспериментальной группах отличается от запланированного. Например, вы задумали разделение 50/50, а получили 45/55. Это сигнал о том, что в системе сплитования есть ошибка: возможен повторный показ варианта одному пользователю, потеря части событий из-за багов трекинга или неправильная логика рандомизации. SRM делает результаты теста невалидными, даже если статистическая значимость достигнута.
SRM встречается довольно часто: в среднем в 5–15% тестов (по данным разных компаний). Для ежедневного мониторинга можно использовать строгий порог p-value < 0.0005, чтобы не ловить ложные срабатывания при множественных проверках.
Боты и пауки искажают данные, так как их поведение не отражает реальных пользователей. Если бот попадает в экспериментальную группу и совершает аномальные действия, это может создать ложный эффект. Технические ошибки в коде, из-за которых часть пользователей не получает вариант или событие не отправляется в аналитику, также ломают рандомизацию. Поэтому перед запуском теста необходимо проверять, что трекинг работает корректно.
Даже при корректном сплитовании возможен дисбаланс по когортам: в одну группу может попасть больше пользователей из SEO-трафика, а в другую — из платной рекламы. Конверсия у этих источников разная, что исказит результат. Обязательно проверяйте распределение по источникам, устройствам и когортам и при необходимости применяйте стратификацию.
Ключевое правило — делать рандомизацию на бэкенде с использованием стойких идентификаторов (например, хэша от user_id), а не на фронте. Вот пример простой функции на Python:
import hashlib

def assign_group(user_id: str):


# Генерируем хэш от user_id, превращаем в число и берём модуль
 user_hash = hashlib.md5(user_id.encode()).hexdigest()
 user_val = int(user_hash, 16) % 100


# Если число < 50 — идёт в группу A, иначе в B
 return 'A' if user_val < 50 else 'B'
Такой подход гарантирует, что один и тот же пользователь всегда попадает в одну и ту же группу, а распределение близко к равномерному. Перед запуском основного теста проверяйте статистику на массиве из 100 000 хэшей: деление должно быть примерно 50/50.
Отдельная проблема — сотрудники компании, которые попадают в тест. Они могут оформлять заказы по телефону, формируя дополнительные продажи в одном сегменте. Это искажает результаты. Рекомендуется фильтровать сотрудников из выборки или учитывать их отдельно. Аналогично нужно исключать влияние операторов call-центра, которые могут обрабатывать заказы вручную и вносить данные в систему.
Ещё одна техническая ошибка — перепутывание шаблона страницы с конкретным вариантом. В интернет-магазинах тысячи карточек товаров часто построены на одном шаблоне. Если вы тестируете изменение на уровне шаблона, но ошибаетесь в настройке, можно случайно применить вариант ко всем страницам, вызвав, например, отображение одной и той же цены. Всегда проверяйте, что тест применяется к правильным шаблонам и страницам.
Множественное тестирование без коррекции
Когда вы одновременно проверяете несколько гипотез или анализируете много метрик, вероятность получить хотя бы один ложноположительный результат резко возрастает. При стандартном пороге значимости 5% и 20 проверяемых метриках шанс хотя бы одной ложной значимости составляет 64% (Команда). Это означает, что вы рискуете внедрить изменение, которое на самом деле не работает, просто из-за случайности.
Чтобы снизить риск, применяют поправку Бонферрони (деление порога на количество тестов) или контроль ожидаемой доли ложных отклонений (FDR). Более продвинутый подход — использовать многорукого бандита, который автоматически перераспределяет трафик в пользу лучшего варианта и снижает количество «пустых» экспериментов. Многорукий бандит особенно полезен, когда цена тестирования высока.
Кроме того, распространена ошибка параллельных тестов на пересекающейся аудитории. Если одна команда тестирует дизайн корзины, а другая — процесс регистрации, пользователи сталкиваются с двумя изменениями одновременно, и невозможно определить, какое именно повлияло на конверсию. Разбивайте пользователей на непересекающиеся группы или запускайте тесты последовательно.
Даже если тесты проводятся на непересекающихся аудиториях, их эффекты могут быть неаддитивны: совместный эффект двух фич не всегда равен сумме индивидуальных. Например, две фичи по отдельности дают +5% и +3%, а вместе — -2%. Поэтому решения по взаимодействующим фичам нужно принимать с учётом их совместного влияния, а не по отдельности.
При автоматизации A/B-тестов проблема множественных сравнений усугубляется: тест по умолчанию запускается на все возможные метрики, и без коррекции вы получите ложные значимости. Например, в А/А-тесте на 100 метриках t-тест детектирует значимые различия в среднем в 4–6 случаях из 100, хотя группы идентичны. Это классический пример проблемы множественных сравнений. Поэтому перед запуском теста ограничьте список метрик только теми, которые действительно относятся к гипотезе, и применяйте поправки (Бонферрони, FDR).
Как правильно подготовить и провести A/B-тест
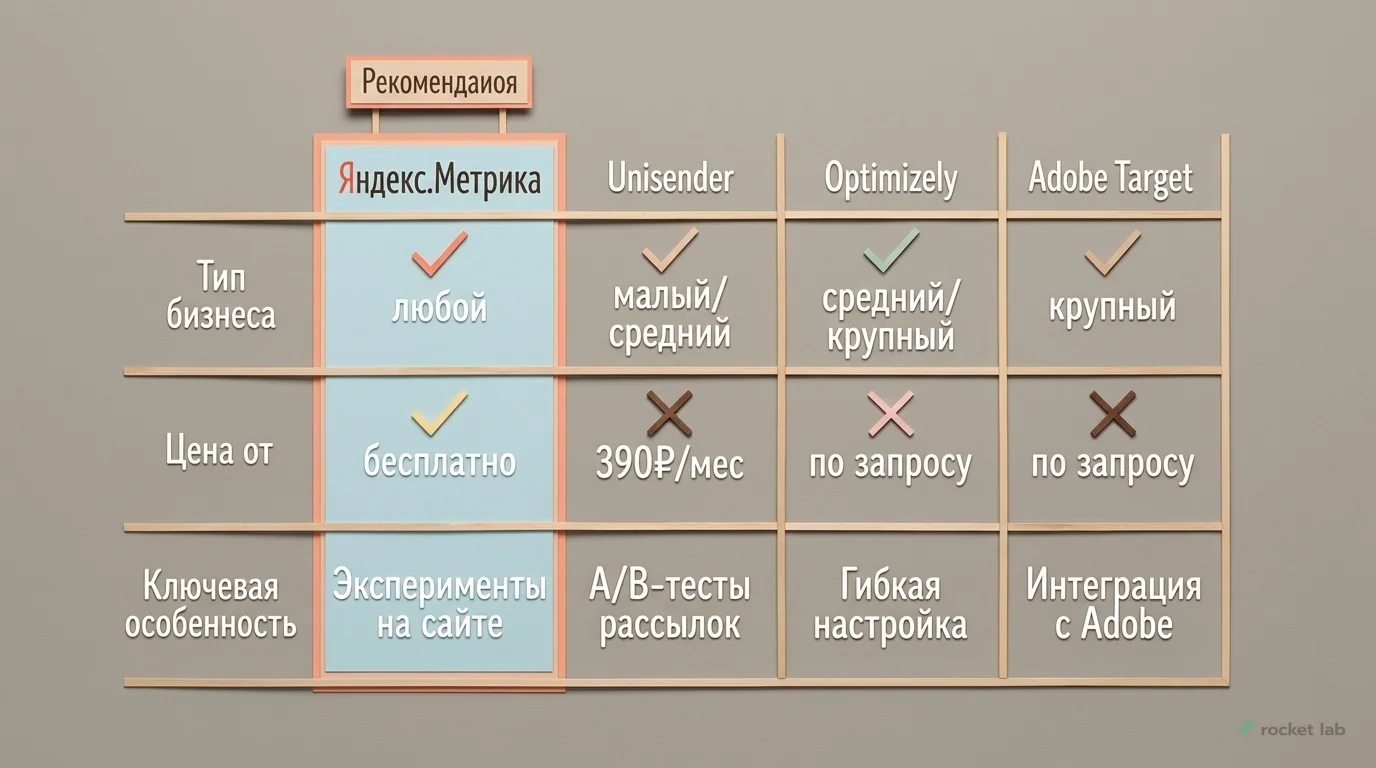
Чтобы избежать перечисленных проблем, нужно подходить к A/B-тестированию как к научному эксперименту. Ниже — пошаговый план подготовки, который сэкономит вам недели и деньги. Для проведения экспериментов можно использовать специализированные платформы и инструменты. Вот краткий обзор популярных решений.
Сравнение платформ для A/B-тестирования
| Название | Тип бизнеса | Цена от | Ключевая особенность |
|---|---|---|---|
| Яндекс.Метрика | любой | бесплатно | Эксперименты на сайте |
| VK Реклама | малый/средний | бесплатно | Сплит-тесты объявлений |
| Unisender | малый/средний | от 390₽/мес | A/B-тесты рассылок |
| Tilda | малый/средний | от 750₽/мес | A/B-тесты страниц |
| Varioqub | любой | по запросу | Агрегация данных в едином интерфейсе |
| Optimizely | средний/крупный | по запросу | Гибкая настройка |
| VWO | средний/крупный | по запросу | Визуальный редактор |
| AB Tasty | средний/крупный | по запросу | AI-персонализация |
| Convert | любой | по запросу | Приватность данных |
| Kameleoon | средний/крупный | по запросу | Прогнозная аналитика |
| Adobe Target | крупный | по запросу | Интеграция с Adobe |
Среди российских инструментов удобны Яндекс.Метрика для экспериментов на сайте и VK Реклама для сплит-тестирования объявлений. Для email-рассылок A/B-тесты поддерживает Unisender, а для сайтов на конструкторе — Tilda. Также стоит обратить внимание на Varioqub — платформу от Яндекса для A/B-тестирования, которая агрегирует данные в едином интерфейсе. Из зарубежных платформ зарекомендовали себя Optimizely, VWO, AB Tasty, Convert, Kameleoon и Adobe Target. Выбор зависит от бюджета и задач.
Чёткая гипотеза — основа успешного эксперимента
Хорошая гипотеза формулируется по шаблону: «Если я изменю [элемент] на [странице/в процессе], то [метрика] изменится на [величина], потому что [причина]». Например: «Если я заменю заголовок на кнопке с «Отправить» на «Получить расчёт», то конверсия в заявку вырастет на 15%, потому что конкретный призыв снижает неопределённость у пользователя». Гипотеза должна быть конкретной и проверяемой.
Возьмём производственную компанию, которая продаёт металлообработку. Вместо «улучшить кнопку» гипотеза звучит так: «Если на странице услуги добавить блок с сертификатами и гарантией, то количество заявок увеличится на 10%, потому что это снижает риски при выборе поставщика». Для B2B-сервиса: «Если сократить форму заявки с 10 полей до 4, то конверсия в демо-заявку вырастет на 20%, потому что пользователи не хотят тратить время на заполнение длинных форм».
Важно: идеи для эксперимента не появляются просто так, они основываются на гипотезах. Если вы тестируете версию А против версии В без чёткой гипотезы, и версия В оказывается лучше на 15%, вы не сможете понять, почему это произошло и как использовать этот результат. Тестирование «ради тестирования» или случайных идей («тестирование спагетти») — пустая трата трафика и времени.
Когда A/B-тест не нужен
Прежде чем запускать эксперимент, стоит понять, а нужен ли он вообще.
Когда A/B-тест не нужен и чем его заменить
Этапы проведения корректного A/B-теста
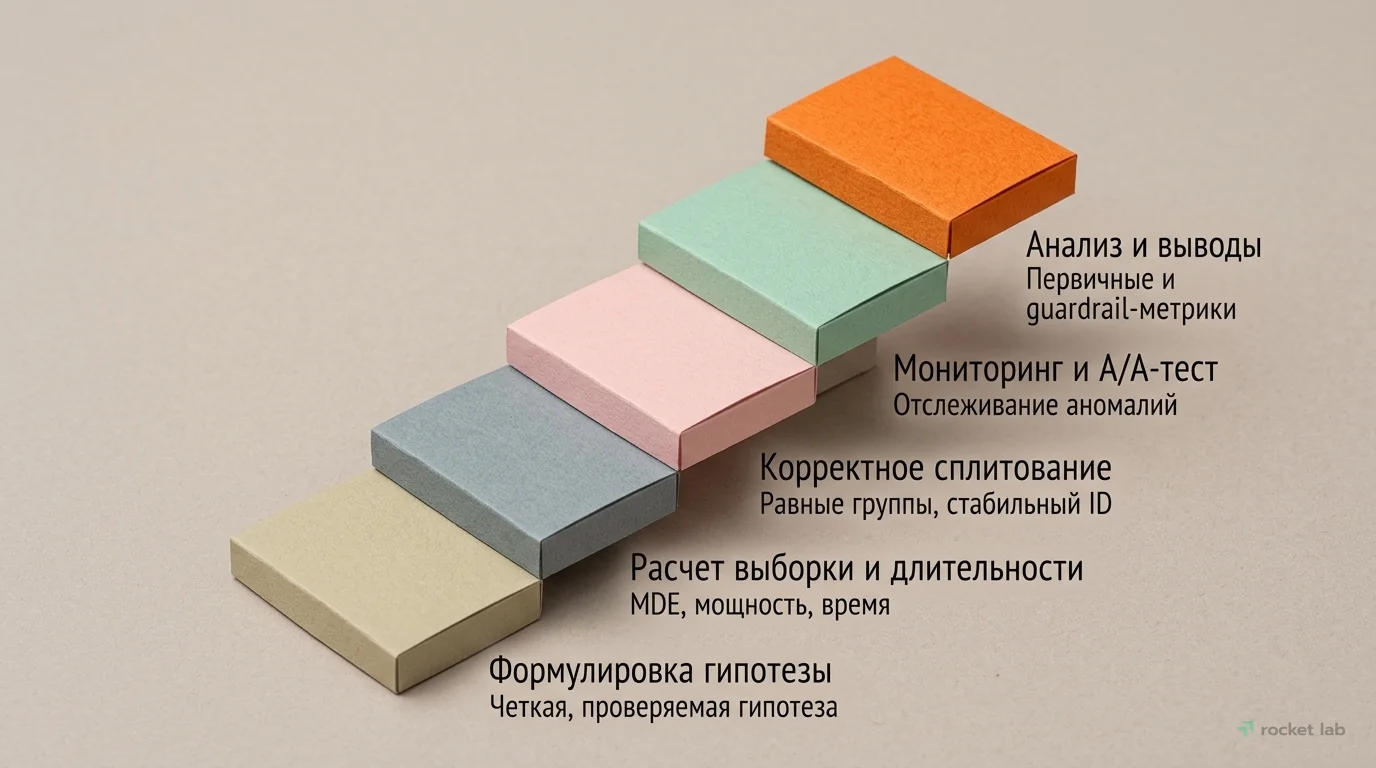
Существуют сценарии, где A/B-тест — пустая трата времени, денег и нервов
- Слишком низкий трафик. Если у вас на страницу заходит 500 человек в месяц, а целевое действие — покупка, которую совершает один из ста, статистически значимый результат вы не получите. Альтернатива — качественные методы: юзабилити-тестирование, опросы, анализ сессий. При 1–2 продажах в месяц вместо теста просто переходите на версию В и смотрите на результат в течение нескольких недель.
- Архитектурные изменения. Если вы переделываете ядро продукта или меняете платёжного провайдера, вы не можете откатить половину пользователей на старую архитектуру. В таких случаях сравнивать нечего.
- Изменения, которые невозможно проверить изолированно. Новый брендинг, смена ценовой политики или ребрендинг мобильного приложения влияют на всё сразу. Здесь уместен анализ временных рядов, а не A/B-тест.
- Очевидные исправления. Если кнопка не видна, её нужно сделать видимой; если форма слишком длинная, её нужно сократить. Тратить неделю на тестирование очевидных вещей — значит терять время.
- Сезонные продукты. Если продукт привязан к конкретному времени года, а тест нужно провести в межсезонье, результаты ничего не скажут о поведении пользователей в пиковый период.
- Недостаточно времени на сбор выборки. Если до срочного события (распродажа, запуск кампании) осталось мало времени, тест не успеет набрать нужное количество данных. Лучше отложить эксперимент.
- Страница уже забита другими тестами. Если на одной странице уже проводятся другие эксперименты, новый тест будет пересекаться с ними, и результаты станут невалидными. Проводите тесты последовательно или на разных страницах.
- Изменение не влияет на конверсию напрямую. Например, тестирование NPS-опроса или других некритичных элементов. Если метрика не связана с бизнес-целью, тест не принесёт пользы.
Какие метрики расскажут правду?
Основная метрика (primary) — это единственный показатель, по которому вы принимаете решение. Она должна отражать бизнес-цель: выручка, конверсия в целевое действие, повторные покупки. Не выбирайте две первичные метрики, иначе при расхождении результатов вы не сможете понять, какой вывод верен. Например, если вы тестируете новый заголовок, primary-метрикой может быть конверсия в заявку, а не время на странице.
Guardrail-метрики — это показатели, которые должны остаться неизменными или не ухудшиться. Они защищают от ситуаций, когда улучшение конверсии достигается за счёт падения качества трафика или роста отказов. Например, при тестировании формы заявки guardrail-метрикой может быть процент возвратов или количество негативных отзывов. Если guardrail-метрика упала, изменение внедрять нельзя, даже если primary-метрика выросла.
Если целевое событие случается редко (например, покупка в B2B), тест может длиться месяцы. В таких случаях используют прокси-метрику — показатель, который коррелирует с целевым действием. Например, для онлайн-школы это может быть регистрация на бесплатный вебинар, а не покупка курса. Прокси-метрика должна быть чувствительной к изменениям и тесно связана с конечной целью, иначе вы рискуете оптимизировать не то.
Отдельная ловушка — нечувствительные метрики. Например, retention через 30 дней не отразит краткосрочные улучшения вовлечённости, если новая функция улучшает только первые сессии. Если целевая метрика редко меняется, используйте прокси-метрики, которые реагируют на промежуточные шаги в воронке.
Избегайте «метрик тщеславия»: лайков, репостов, просмотров. Если они не влияют на конверсию в продажу, тест на их основе приведёт к неверным выводам. Количественные данные показывают, что пользователи не кликнули, но не объясняют почему. Дополняйте тесты качественными исследованиями — юзабилити-тестами и интервью, чтобы понять причины поведения.
Частая ошибка — выбирать только верхнеуровневые метрики (выручка, конверсия в покупку) или только низкоуровневые (CTR, время на странице). Правильный подход — комбинировать их. Сначала анализируйте низкоуровневые метрики, чтобы понять, как изменение влияет на поведение пользователей, но затем обязательно проверяйте, как это отражается на бизнес-показателях. Пример: в e-commerce более заметная кнопка «Добавить в корзину» может повысить CTR, но одновременно вырастет число брошенных корзин и снизится среднее время сессии. Итоговая выручка не изменится или упадёт. Только совместный анализ низкоуровневых и высокоуровневых метрик даёт полную картину.
От сырых событий к осмысленным выводам
Одна из частых ошибок на этапе подготовки — использование сырых пособытийных данных напрямую. Один пользователь может генерировать множество событий (клики, просмотры, заказы), и эти события не являются независимыми. Если анализировать их напрямую, ошибка первого рода возрастает: вы будете чаще, чем нужно, говорить о наличии эффекта, которого на самом деле нет.
Правильный подход — агрегировать данные на уровне пользователя перед анализом: рассчитать сумму соответствующих метрик для каждого пользователя и использовать этот агрегатный набор. Однако для метрик-отношений (например, доля принятых заявок = принятые заявки / общие заявки) агрегация на уровне пользователя не подходит. Гипотеза равенства средних от отношений на пользователя не совпадает с гипотезой равенства глобальных отношений.
Для метрик-отношений используют продвинутые методы: бакетную агрегацию (разбить пользователей на случайные бакеты, посчитать метрику в каждом бакете) или метод квазиметрик (линейная комбинация пользовательских числителя и знаменателя). Эти методы сложнее, но они сохраняют корректность выводов.
Расчёт размера выборки и длительности теста
Длительность теста зависит от размера выборки, трафика и частоты целевого события. Чем ниже конверсия, тем больше времени нужно для накопления статистически значимых данных. Например, при конверсии 1% и 1000 посетителей в день тест может занять 3–4 недели. Также учитывайте, что тест должен охватывать как минимум один полный недельный цикл, чтобы учесть разницу в поведении пользователей в будни и выходные.
Недельный минимум объясняется тем, что поведение пользователей в разные дни недели сильно различается. Если вы запустите тест в среду и остановите в воскресенье, вы увидите только часть цикла. Кроме того, в течение недели могут происходить события, которые влияют на всех пользователей, например, выход нового письма или публикация в соцсетях. Поэтому тест длительностью менее 7 дней практически всегда невалиден.
Подводные камни сплитования
Главное правило сплитования — пользователь должен попадать в одну и ту же группу при каждом визите. Для этого используют стабильный идентификатор (user_id или cookie) и хэширование. Хэш от идентификатора делится на 100, и остаток определяет группу. Например, если остаток меньше 50 — контрольная группа, иначе — экспериментальная. Такой подход гарантирует, что пользователь не «перепрыгнет» из группы в группу при обновлении страницы.
Перед запуском теста проверьте, что соотношение пользователей в группах соответствует ожидаемому. Для этого проведите A/A-тест: разделите трафик на две одинаковые группы без изменений и убедитесь, что разница в конверсии находится в пределах случайных колебаний. Если разница превышает 2–3%, значит, в системе сплитования есть ошибка, которую нужно исправить до начала эксперимента.
Также избегайте последовательного показа вариантов: сначала контрольная версия неделю, потом тестовая неделю. Любой внешний всплеск трафика в этот период исказит сравнение. Варианты должны показываться одновременно. И ещё одно правило: через несколько дней после запуска всегда проверяйте равномерность деления трафика по всем доступным срезам — городу, браузеру, платформе, источнику трафика.
Даже если тест показывает средний эффект по всей аудитории, разные сегменты могут реагировать по-разному. Например, новая функция может быть популярна среди молодых пользователей, но не работать у пользователей старше 50 лет. Если сегментация выявила неоднородность, не спешите внедрять изменение для всех. Проведите повторный эксперимент, нацеленный только на тот сегмент, где эффект положительный, чтобы подтвердить результат. Если полноценная сегментация невозможна, хотя бы сравните итоги теста с вашим ключевым сегментом — так вы поймёте, насколько выводы соответствуют основной аудитории.
Держать руку на пульсе теста
A/A-тест — это тест, в котором обе группы получают одинаковый вариант. Он позволяет проверить, корректно ли работает система рандомизации и сбора данных. Если в A/A-тесте обнаружена статистически значимая разница, значит, есть техническая проблема: утечка данных, боты или несимметричная загрузка страниц. A/A-тест рекомендуется проводить при настройке новой платформы или после изменения кода.
Однако даже успешный одиночный A/A-тест не гарантирует отсутствия аномалий. На больших объёмах трафика сильные выбросы (например, пользователь с аномально крупным заказом) могут существенно исказить такие метрики, как средняя выручка на пользователя. Чтобы выявить такие проблемы, можно провести симуляцию множества A/A-тестов: случайным образом разделить исторический трафик на две группы, посчитать значимость расхождения, повторить это много раз и построить гистограмму распределения p-value. Если распределение равномерное — трафик чистый, если нет — в данных есть аномалии, и стоит использовать метрики, менее чувствительные к выбросам (например, медиану вместо среднего).
Во время эксперимента необходимо ежедневно мониторить ключевые показатели: количество пользователей в каждой группе, количество событий, скорость загрузки страниц. Аномалии, такие как резкий рост ошибок 404 или падение числа событий, могут означать, что вариант отображается некорректно или трекинг сломан. Если вы обнаружили сбой, лучше остановить тест и запустить его заново после исправления.
Технические ошибки — одна из самых коварных проблем. Кеш может показать пользователю старую версию страницы, блокировщик рекламы — не дать отправить событие в аналитику, сбой в cookie — заново распределить человека в другую группу, а разрыв сессии — учесть одного пользователя несколько раз. Ещё одна частая проблема — событие уходит в аналитику раньше, чем система назначила пользователю вариант теста. Всё это искажает результаты.
Полезно внедрить практику ревью дизайна эксперимента коллегами перед запуском: это позволяет выявить ошибки в гипотезе, метриках и логике сплитования на раннем этапе.
Ещё одна распространённая проблема — запуск параметра теста до начала эксперимента. В некоторых системах, если тест заведён, но не включён, пользователи всё равно начинают назначаться в контрольную группу. При старте данные выравниваются, но остаётся небольшой зазор. Чтобы избежать этого, заранее создайте когорту пользователей, которые заходили с даты заведения параметра до даты старта теста, и исключите её из анализа.
Важно интегрировать данные теста с системой аналитики. Если вы используете отдельную платформу для A/B-тестов, убедитесь, что параметры теста передаются в вашу основную аналитику (например, Яндекс.Метрику). В противном случае вы не сможете проверить, корректно ли делится трафик, и не заметите, что часть пользователей видит обе версии из-за сброса cookie.
Зачем вести дневник экспериментов?
Каждый A/B-тест — это не только оптимизация продукта, но и ценный урок. Если вы не фиксируете результаты, вы теряете накопленный опыт. Заведите корпоративную базу знаний — Notion, Confluence или хотя бы Google Таблицу — и записывайте туда:
- Как выглядел пользовательский опыт (что именно тестировалось).
- На каких пользователях проводился тест (сегменты, аудитория).
- Гипотезу и метрики.
- Результаты с доверительными интервалами и размерами эффекта.
- Выводы: что сработало, что нет и почему.
Такая база помогает командам не повторять одни и те же ошибки, быстрее генерировать новые гипотезы и обосновывать решения перед руководством. Особенно это полезно, когда над продуктом работает несколько команд.
Типичные ошибки, которые убивают достоверность
Отсутствие чёткой гипотезы и метрик
Многие компании запускают A/B-тесты без чёткой гипотезы, просто чтобы «попробовать». Это приводит к хаотичным изменениям, которые не подкреплены логикой. Например, смена цвета кнопки без объяснения, почему это должно повлиять на конверсию, — типичная ошибка. Такие тесты редко приносят пользу, а их результаты невозможно интерпретировать.
Один из наших клиентов — логистическая компания — решила тестировать новую форму заказа. Вместо гипотезы они просто изменили расположение полей. Тест показал статистическую значимость, но после внедрения количество заявок не изменилось, а время заполнения формы выросло. Причина — отсутствие чёткой гипотезы и выбор неправильной метрики. В итоге компания потратила месяц на эксперимент, который не дал результата.
Подглядывание в результаты (peeking)
Эффект дня сурка в A/B тестировании — это ситуация, когда команда каждый день проверяет результаты теста и при малейшем преимуществе одного варианта останавливает эксперимент. На следующий день преимущество исчезает, и команда запускает новый тест, который снова останавливает слишком рано. Так продолжается бесконечно, потому что при ежедневном просмотре данных вероятность ложного срабатывания близка к 100%.
Остановка теста при первом же значимом результате — самая дорогая ошибка, которую мы встречали в практике.
Клининговая компания из нашей практики тестировала новую структуру прайс-листа. Через три дня вариант А показал рост конверсии на 25%, и владелец бизнеса остановил тест. Через неделю конверсия упала до прежнего уровня, потому что первоначальный рост был связан с наплывом случайных заказов. Компания потеряла две недели на внедрение неработающего изменения и вернулась к старой версии.
Неправильная рандомизация и сдвиг выборки
В автосервисе, который тестировал новую форму записи, контрольная группа получила 40% трафика, а экспериментальная — 60%. Это произошло из-за того, что система сплитования использовала дату и время, а не стабильный идентификатор. Пользователи, пришедшие в разное время, попадали в разные группы, что привело к искажению результатов. Тест пришлось остановить и перезапустить после исправления алгоритма.
Чтобы выявить SRM, регулярно сравнивайте фактическое распределение трафика с ожидаемым с помощью теста хи-квадрат. Если p-value меньше 0.05, значит, дисбаланс не случаен. Исправление может потребовать замены алгоритма рандомизации, очистки данных от ботов или настройки трекинга. После исправления обязательно проведите A/A-тест для подтверждения корректности.
Игнорирование сезонности и внешних факторов
Онлайн-школа запустила тест нового лендинга в конце августа, когда спрос на курсы традиционно высок. Тест показал, что новый лендинг работает лучше старого. Однако в сентябре, когда спрос упал, конверсия нового лендинга оказалась ниже. Если бы школа учла сезонность, она бы не стала внедрять изменения. Аналогичная ситуация возможна в медицинском центре, где тест на страницу записи к врачу, проведённый во время эпидемии гриппа, даст искажённые результаты.
Учитывайте внешние факторы на этапе планирования: избегайте запуска тестов в периоды известных событий (праздники, крупные рекламные кампании). Если тест уже запущен и вы заметили аномальный внешний трафик, добавьте его в анализ как коварианту или проведите сегментацию по источнику трафика. Также полезно сравнивать результаты с историческими данными за аналогичный период.
Фокус только на статистической значимости
Статистическая значимость говорит о том, что результат вряд ли случаен, но не говорит о том, что он важен для бизнеса. Практическая значимость — это минимальный эффект, который оправдывает внедрение. Например, рост конверсии на 0.1% может быть статистически значимым при огромной выборке, но экономически бессмысленным, если выручка с одного клиента невелика.
Небольшой эффект стоит внедрять, если затраты на его реализацию минимальны, а масштаб трафика велик. Например, улучшение конверсии на 0.2% (Калькулятор) на сайте с миллионом посетителей в месяц даст 2000 дополнительных конверсий. Но для маленького сайта такой же прирост не окупит усилий. Всегда оценивайте эффект в деньгах, а не в процентах.
Игнорирование доверительных интервалов и размера эффекта
Некоторые аналитики смотрят только на p-value и забывают про доверительные интервалы. Даже если разница статистически значима, но доверительные интервалы сильно пересекаются — эффект сомнителен. Всегда оценивайте не только p-value, но и величину эффекта. Полезно задать порог заранее: «Мы внедрим новое решение только если конверсия вырастет минимум на 2%». Это защищает от внедрения микроскопических улучшений, которые не окупают затраты на реализацию.
При этом важно различать абсолютный прирост (в процентных пунктах) и относительный (в процентах к базе). Прирост +0,4 п.п. на базе 3,2% — это +12,5% относительно. Относительная цифра всегда выглядит внушительнее, поэтому при чтении отчётов держите в голове обе.
Непроверенная реализация варианта
Если вариант содержит ошибку в коде, например, неправильно настроен трекинг кликов или сломан элемент на странице, тест покажет ложные результаты. Пользователь может не увидеть изменение или, наоборот, увидеть его не полностью. Баги часто не видны на первый взгляд, поэтому перед запуском нужно провести полное QA: проверить отображение в разных браузерах, скорость загрузки, работу трекинга.
Юридическая фирма тестировала новую форму обратного звонка. Из-за бага в JavaScript форма не отправляла данные в CRM, но визуально выглядела рабочей. Тест показал «рост» числа заявок, потому что пользователи кликали по кнопке, но на самом деле заявки терялись. Компания потеряла две недели и несколько потенциальных клиентов, прежде чем обнаружила ошибку.
Изменение варианта по ходу теста
Нельзя менять функционал варианта B, когда тест уже запущен. Если менеджер просит добавить новую акцию или изменить элемент в середине эксперимента, вы не сможете понять, какое именно изменение повлияло на результат. Сравнение становится некорректным. Если нужно внести изменение — останавливайте тест и запускайте новый эксперимент. Чтобы минимизировать риск, изолируйте вариант B в отдельный компонент кода, чтобы изменения в основной код не затронули группу B.
Когда одной переменной мало
Классический A/B-тест сравнивает две версии, но на практике часто нужно проверить сразу несколько гипотез или комбинаций. Для этого используют многовариантное тестирование (MVT) и A/B/n-тесты.
A/B/n-тест сравнивает сразу несколько вариантов (A, B, C, D и т.д.) в одном эксперименте. Например, вы хотите выбрать оптимальное количество офферов в блоке: два, три или четыре. Вместо последовательных A/B-тестов можно запустить один A/B/n-тест со всеми вариантами одновременно. Это экономит время и позволяет сравнить все варианты в одинаковых условиях. Однако такой тест требует больше трафика, так как каждый вариант получает меньшую долю пользователей.
MVT изменяет несколько элементов одновременно и позволяет оценить их совместное влияние. Например, вы меняете цвет кнопки и текст на ней. MVT покажет, какое сочетание даёт лучший результат. Но количество комбинаций растёт экспоненциально, поэтому для MVT нужен очень большой трафик. Обычно MVT применяют на высоконагруженных сайтах.
Если пользователи могут влиять друг на друга (например, в социальных продуктах), классический A/B-тест некорректен. В таких случаях используют switchback-эксперименты: версии продукта чередуются во времени или по локациям. Например, в один день все пользователи видят версию A, на следующий — версию B. Это снижает риск взаимного влияния.
Эти методы — не замена A/B-тестам, а дополнение. Выбирайте их в зависимости от задачи и доступного трафика.
Что запомнить
- Определите одну primary-метрику и сформулируйте гипотезу до запуска теста.
- Рассчитайте необходимый размер выборки и длительность эксперимента заранее.
- Контролируйте рандомизацию и проверяйте равномерность сплитования с помощью A/A-теста.
- Не останавливайте тест преждевременно и не подглядывайте в результаты каждый день.
- Учитывайте внешние факторы и сезонность при планировании и анализе.
- Используйте стойкие идентификаторы и хэширование для рандомизации на бэкенде.
- Агрегируйте данные на уровне пользователя перед анализом.
- Не меняйте вариант B по ходу теста — при необходимости остановите и перезапустите эксперимент.
- Смотрите не только на p-value, но и на доверительные интервалы и размер эффекта.
- Комбинируйте низкоуровневые и высокоуровневые метрики для полной картины.
- Документируйте каждый тест, чтобы накапливать базу знаний для команды.
Частые вопросы (FAQ)
Можно ли проводить несколько A/B-тестов одновременно?
Да, но только если они не влияют друг на друга и используют разные сегменты аудитории или разные страницы. Если тесты пересекаются на одних и тех же пользователях, результаты станут невалидными. В идеале запускайте один тест на страницу, чтобы избежать путаницы.
Как быть, если трафика слишком мало для A/B-теста?
При низком трафике A/B-тест может занять слишком много времени. Рассмотрите альтернативы: многорукий бандит, который быстрее находит лучший вариант, или качественные исследования — юзабилити-тесты и интервью с пользователями. Также можно использовать прокси-метрики, чтобы сократить время сбора данных.
Что такое практическая значимость и почему она важна?
Практическая значимость — это минимальный положительный эффект, который оправдывает внедрение изменения с точки зрения бизнеса. Статистическая значимость лишь подтверждает, что результат не случаен, но не гарантирует его пользу. Оценивайте, сколько дополнительной выручки принесет изменение, прежде чем принимать решение.
Влияют ли внешние факторы на результаты A/B-тестирования?
Да, внешние факторы — сезонность, рекламные кампании, изменения в поведении пользователей — могут исказить результаты. Чтобы минимизировать влияние, не запускайте тесты в периоды аномальной активности и учитывайте исторические данные при анализе. Также можно использовать сегментацию по источнику трафика.
Что такое A/A-тест и зачем он нужен?
A/A-тест — это эксперимент, в котором обе группы получают одинаковый вариант. Он нужен для проверки корректности системы сплитования и сбора данных. Если A/A-тест показывает значимую разницу, значит, в системе есть ошибка, которую нужно исправить перед запуском основных тестов.
Что такое Sample Ratio Mismatch (SRM)?
SRM — это несоответствие пропорции выборок: например, группы должны делиться 50/50, но одна стабильно получает больше пользователей. Это сигнал об ошибке в распределении трафика, идентификаторе пользователя или трекинге событий. Результатам такого теста доверять нельзя.
Почему нельзя использовать сырые данные о событиях?
События одного пользователя не являются независимыми, и их использование напрямую увеличивает вероятность ошибки первого рода — вы чаще будете видеть «эффект», которого нет. Перед анализом агрегируйте данные на уровне пользователя.