

Большие языковые модели (LLM) трансформируют способы поиска и потребления информации, анализируя контекст, выявляя связи и цитируя источники. Для владельцев контента это означает необходимость переосмыслить свои стратегии, чтобы их материалы были понятными, релевантными и цитируемыми AI. В этой статье разберём, как LLM выбирают источники, какие характеристики контента повышают вероятность цитирования и как измерять эффективность в новой реальности.
Почему цитируемость стала новой валютой
Традиционный поиск показывал ссылки на страницы, и пользователь сам решал, куда кликнуть. Теперь генеративные модели собирают ответ из нескольких источников и выдают готовый текст. Ваш контент может не получить ни одного клика, но при этом лечь в основу ответа AI. И наоборот: страница без цитирования в ответах модели теряет охват.
Преимущества и риски GEO
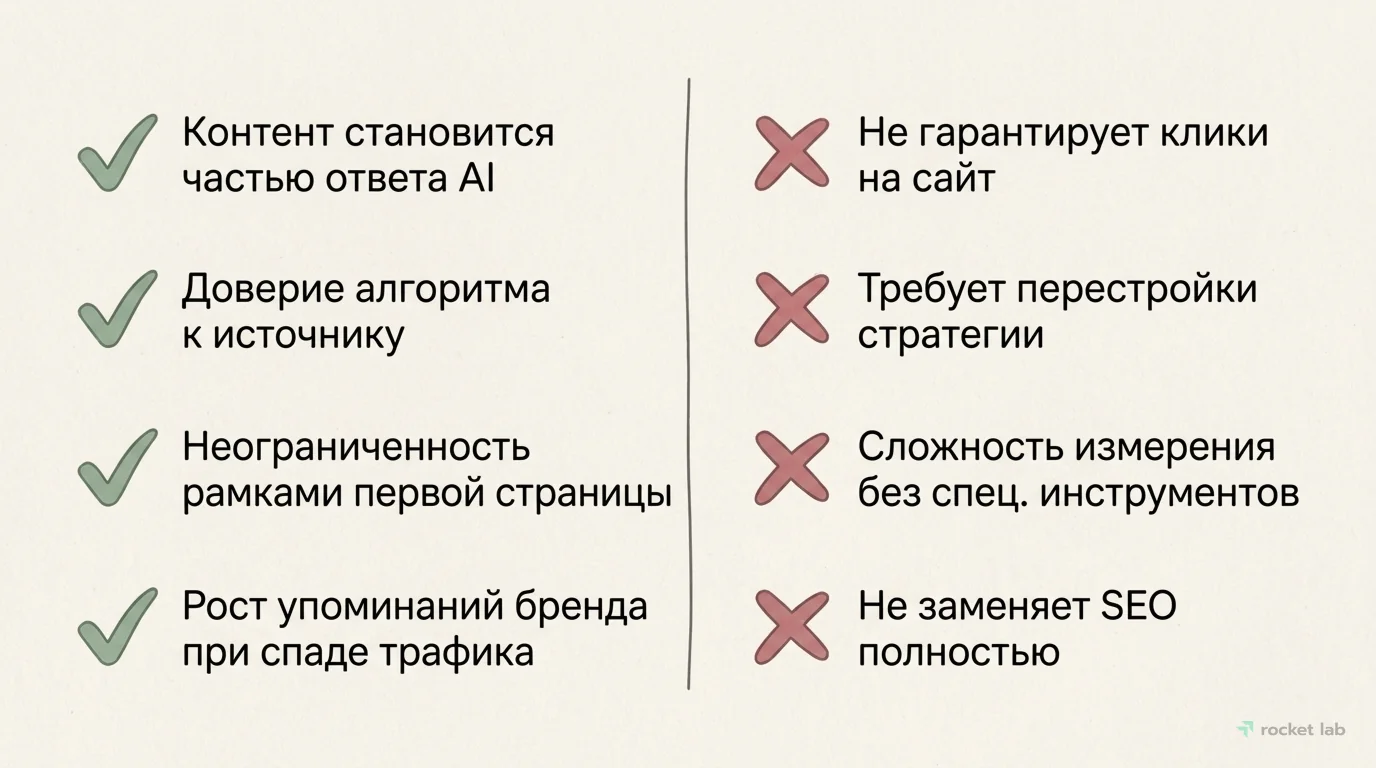
Цитируемость показывает, насколько ваша информация ценна для алгоритмов, которые формируют мнение пользователей. В отличие от позиций в поисковой выдаче, цитирование не ограничено рамками первой страницы: оно происходит в реальном времени внутри диалога с AI.
Я наблюдаю это в работе с клиентами каждый месяц: трафик с классического поиска может проседать, а число упоминаний бренда в ответах нейросетей при этом растёт. И это нормально. Просто правила игры изменились.
Переход от позиций к вероятностям
В классическом SEO вы стремились попасть в топ-10 выдачи. LLM так не работает. Модель оценивает множество документов и присваивает каждому вероятность быть использованным в ответе. Высокая позиция в SERP не гарантирует попадание в этот пул, а страница со второй страницы может оказаться релевантной для конкретного запроса.
По оценкам экспертов, к 2026 году более 50% (Искусственный) поисковых запросов будут обрабатываться генеративными моделями. При этом более 70% информационных запросов удовлетворяются непосредственно в интерфейсе чат-бота или поисковика без перехода на сайт. Вместо гонки за первым местом нужно добиваться включения вашего контента в набор источников, которые модель считает достоверными.
Запросы к LLM принципиально отличаются от традиционных: средняя длина запроса в AI-поиске составляет 23 слова против 4 в классическом поиске, а сеансы длятся в среднем 6 минут. Пользователь ожидает развёрнутых ответов, а не коротких сниппетов. Контент должен быть глубже и покрывать больше смежных тем.
Что такое Generative Engine Optimization (GEO)
GEO (оптимизация под генеративные движки) — это практика адаптации контента таким образом, чтобы большие языковые модели выбирали его для формирования ответов. SEO нацелено на ранжирование в списке ссылок, GEO — на то, чтобы ваш текст стал частью ответа AI.
GEO включает работу над семантической структурой, авторитетностью домена, полнотой раскрытия темы и использованием данных, которые модель может легко извлечь. Это надстройка над SEO: хороший SEO-контент может быть полностью невидимым для LLM, если не учитывать их алгоритмы отбора.
Двухэтапная модель выбора источников
Поиск кандидатов (retrieval)
На первом этапе модель извлекает потенциально релевантные документы. Обычно это от 20 до 50 кандидатов. Здесь работают традиционные сигналы: ключевые слова, семантическое сходство, наличие структурированных данных. Если ваш контент не содержит точных формулировок запроса или не имеет разметки, он не попадёт даже в короткий список.
Отбор и ранжирование (re-ranking and selection)
После предварительного отбора модель оценивает качество каждого документа и выбирает 3–8 лучших. В ход идут авторитетность источника, свежесть данных, полнота ответа и наличие уникальных фактов. Именно здесь решается, будет ли ваш контент процитирован. Структурированный источник с 5-й позиции нередко обходит сплошной абзац с 1-й.
Цитируемость — это прямое включение данных вашего сайта в ответ AI. Поэтому борьба идёт не за клик, а за доверие алгоритма.
Характеристики контента, который LLM склонны цитировать
LLM не случайно выбирают источники. Есть закономерности, которые повышают вероятность цитирования.
Факторы цитируемости контента LLM
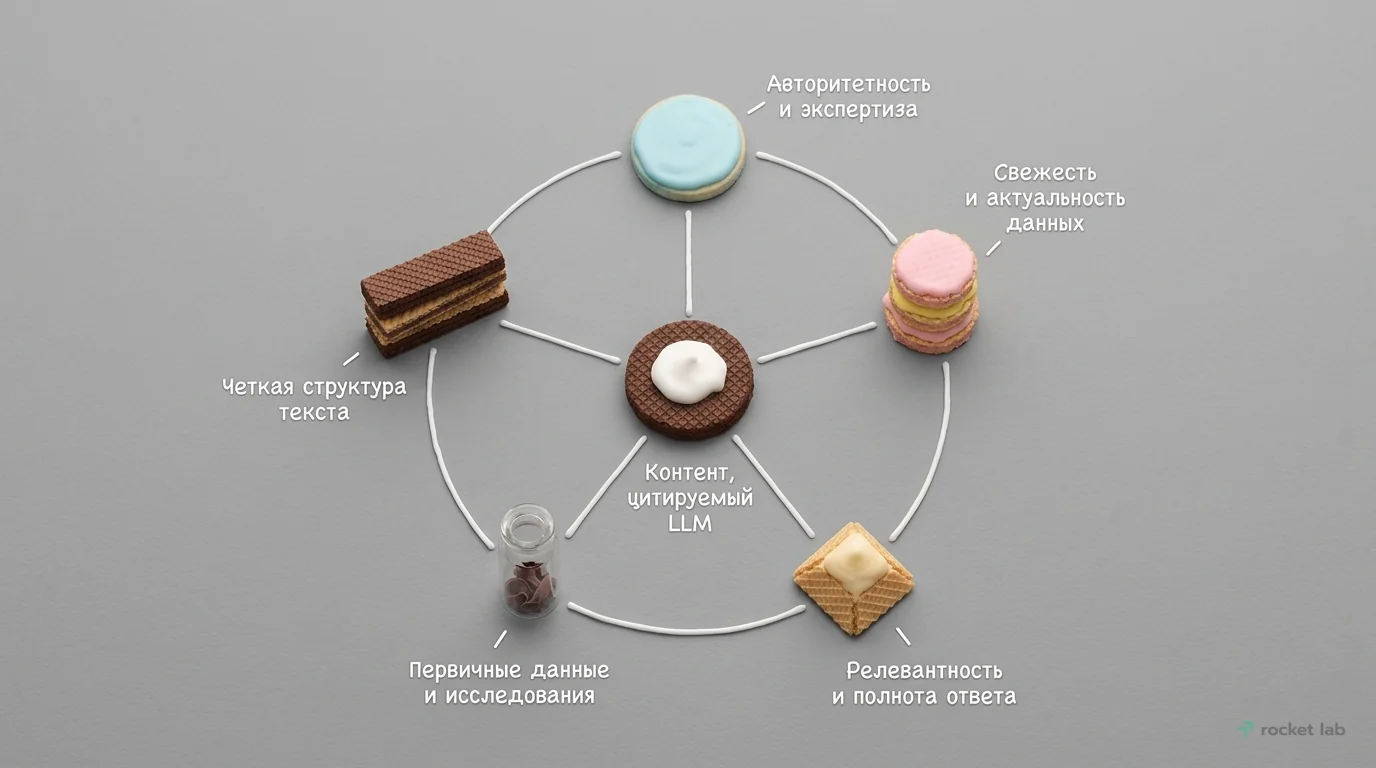
Авторитетность и экспертиза
Модели отдают предпочтение материалам, где указан автор с релевантным опытом. Статья с подписью «эксперт по машинному обучению, PhD в области NLP» будет воспринята надёжнее, чем анонимный текст. Если ваш контент не содержит информации об авторе, добавьте её. Это простой способ повысить шансы на цитирование.
Источники с доменами.edu,.gov, а также публикации, на которые ссылаются научные работы, получают преимущество. Если ваш контент не может похвастаться таким авторитетом, создайте перекрёстные ссылки на исследования и официальные отчёты. Это покажет модели, что вы опираетесь на проверенные данные.
Свежесть и актуальность данных
LLM обучены на срезах данных, но при формировании ответа учитывают дату публикации. Статья, обновлённая в течение последних месяцев, имеет больше шансов быть использованной, чем устаревшая, даже если последняя более полная. Регулярно актуализируйте контент, особенно в быстро меняющихся областях: технологиях, законодательстве, маркетинге.
В сферах, где данные устаревают за считанные недели, свежесть становится решающим фактором. Например, в отраслях с частыми изменениями регуляторики или курсов валют LLM отдаёт приоритет материалам с датой публикации не старше нескольких дней.
Релевантность и полнота ответа
Модель оценивает, насколько текст соответствует смыслу запроса, а не просто содержит ключевые слова. Чем точнее ваш контент отвечает на подразумеваемый вопрос пользователя, тем выше его релевантность. Изучайте смежные запросы и покрывайте все подтемы, чтобы модель могла найти у вас недостающую деталь.
LLM предпочитают источники, где вопрос раскрыт полностью. Если пользователь спрашивает «как выбрать CRM», а у вас только общие слова о преимуществах, модель скорее выберет статью с пошаговым алгоритмом и сравнением систем. Длинный, детализированный контент с практическими рекомендациями цитируется в разы чаще коротких поверхностных заметок.
Первичные данные и оригинальные исследования
Уникальные данные — золото для LLM. Модель не может «выдумать» цифры, поэтому ищет источники с конкретными показателями. Проведите собственный опрос клиентов или соберите статистику по своей отрасли — вероятность цитирования резко возрастёт.
Один из наших клиентов, B2B-компания из сферы логистики, опубликовала отчёт о собственных исследованиях рынка. Через три месяца этот отчёт цитировали три разные LLM в ответах на запросы о трендах логистики. Без единого клика по ссылке. Модель находила в отчёте цифры, которых не было больше нигде, и вставляла их в свои ответы.
Простые пересказы чужих идей не представляют ценности. LLM нужны аналитические материалы с выводами, которые нельзя найти в другом месте. Проведите анализ трендов, предложите новую классификацию или опишите практический кейс — и модель выделит ваш контент из массы однотипных статей.
Как структура текста влияет на цитируемость LLM
Алгоритмы машинного обучения обрабатывают текст как последовательность токенов. Чем понятнее структура, тем проще модели выделить ключевые блоки и процитировать их.
Заголовки и подзаголовки как дорожные знаки для AI
Чёткая иерархия заголовков помогает модели понять смысловое деление документа. Используйте один H1, несколько H2 и подразделы H3-H4 для разбивки на блоки. Без иерархии модель может неверно интерпретировать структуру и пропустить важные части текста.
Заголовки должны содержать не только общие фразы, но и точные ключевые слова, по которым пользователь ищет информацию. Это повышает семантическую близость контента к запросу и упрощает модели задачу извлечения релевантных фрагментов.
Списки и таблицы как готовые блоки информации
LLM легко извлекают данные из списков. Если вы перечисляете преимущества, шаги или критерии, оформляйте их в виде маркированных или нумерованных списков. Это структурирует информацию и делает её пригодной для прямого копирования в ответ.
Таблицы — настоящий клад для LLM. Они позволяют модели быстро находить конкретные значения и сравнивать характеристики. Если в вашей статье есть сравнение продуктов, цен или методов, обязательно используйте таблицу. Это увеличивает шанс, что именно ваша таблица станет основой для ответа AI.
Ясность и краткость формулировок
Большие блоки текста сложнее парсить. Разбивайте текст на абзацы по 2-3 предложения, каждый из которых содержит одну законченную мысль. Такой формат облегчает модели выделение ключевых утверждений.
Избегайте двусмысленности и «воды». LLM лучше всего работают с чёткими утверждениями вида «A приводит к B», «стоимость составляет X рублей». Конкретные цифры, факты и однозначные формулировки делают контент более машиночитаемым.
Роль чётких определений и глоссариев
Если вы используете профессиональную терминологию, давайте определения при первом упоминании. Модель может не знать контекст вашей отрасли, и точное определение поможет ей корректно интерпретировать остальной текст.
Разметка Schema.org помогает моделям точно понимать типы данных: статьи, организации, продукты, отзывы. Внедрение микроразметки на страницы контента увеличивает шансы, что LLM распознает вашу информацию как структурированную и заслуживающую доверия.
Методы повышения цитируемости вашего контента
Теперь перейдём от теории к практике. Что конкретно можно сделать, чтобы ваш контент стал чаще цитироваться LLM?
Структурирование контента для AI-индексации
Каждый раздел статьи должен отвечать на конкретный вопрос. Начинайте с краткого резюме, затем раскрывайте детали. Такая структура позволяет модели быстро находить нужный фрагмент. Например, если ваша статья о выборе подрядчика, разделите её на блоки: критерии выбора, типичные ошибки, чек-лист проверки.
В конце каждого раздела добавляйте 1-2 предложения с главным выводом. Это «строительные блоки», которые LLM может процитировать дословно. Резюме должны быть самодостаточными и содержать конкретику, а не общие фразы.
Оформление ключевых идей и данных
Смысловое выделение помогает модели понять, что вы считаете главным. Используйте жирный шрифт для терминов и цифр, курсив для примеров. Это улучшает читаемость и даёт алгоритму подсказку, какие фрагменты наиболее значимы.
LLM не читают изображения напрямую, но анализируют альтернативный текст и подписи. Создавайте подробные текстовые описания для каждой инфографики или графика. Укажите ключевые цифры и выводы в подписи — тогда модель сможет использовать эти данные в ответе.
Создание «строительных блоков» информации
Продумайте, какие вопросы пользователь может задать по вашей теме, и дайте на них явные ответы. Например, в статье о лидогенерации добавьте блок «Какой бюджет нужен на старте?» с конкретными цифрами. Такой подход увеличивает шансы, что ваш контент будет использован для ответа на уточняющие запросы.
LLM любят структурированные инструкции. Оформляйте последовательности действий в виде нумерованных шагов с понятными формулировками. Это повышает информационную плотность контента и делает его пригодным для прямого цитирования.
Контрастная семантика — это блоки, объясняющие, чем объект не является. Например, в статье о CRM-системах можно добавить раздел «Что CRM не делает»: «CRM не заменяет маркетинговую автоматизацию, не управляет складскими остатками и не обрабатывает платежи». Такие уточнения помогают LLM точнее понять границы понятия и снижают риск неверной интерпретации.
По данным контент-агентства Kokoc, внедрение контрастной семантики повышает вероятность цитирования в AI-ответах на 70%. Модель получает явные отрицательные определения, которые редко встречаются в стандартных текстах.
Техническая архитектура и граф-контент
Традиционные CMS (WordPress, Wix, Joomla) могут требовать значительной доработки для семантической разметки. Современные headless CMS (Contentful, Strapi, Sanity) предоставляют большую гибкость: они разделяют контент и его представление, что упрощает создание структурированных данных.

Граф-контент — это система, где каждая сущность (человек, продукт, концепция) представлена как узел, а связи между ними — как рёбра. Создание такого графа помогает LLM выявлять неочевидные взаимосвязи и повышает вероятность цитирования.
Для реализации: идентифицируйте ключевые сущности, описывайте их через Schema.org и JSON-LD, связывайте тематические статьи внутренними ссылками, при необходимости используйте открытые онтологии (Wikidata, DBpedia). Инструменты типа Neo4j или Gephi помогут визуализировать граф и найти «узкие места».
Для улучшения семантической близости используйте кластеризацию интентов на основе эмбеддингов: группируйте запросы по смыслу и создавайте контент, покрывающий целые кластеры намерений. Это позволяет отвечать на несколько смежных вопросов в одном материале, что повышает его ценность для LLM.
Также полезно создавать JSON-фиды и открытые таблицы данных для RAG-сценариев: структурированные машиночитаемые данные, которые модель может быстро извлечь и использовать в ответе. Такие «знания-хранилища» особенно эффективны для YMYL-тем, где важна точность и проверяемость фактов.
Помимо оптимизации собственного сайта, эффективной стратегией является посев контента — размещение материалов на платформах, которые LLM используют для обучения или обращения в реальном времени. К таким площадкам относятся Wikipedia, GitHub, Stack Overflow, Medium, а также отраслевые каталоги и форумы.
Алгоритм действий: выберите релевантные авторитетные платформы, создайте уникальный контент, соответствующий их формату и правилам, обеспечьте его ценность для сообщества (лайки, комментарии, репосты). Это повышает шансы попадания в обучающие выборки и в ответы моделей, особенно для узкоспециализированных тем, где мало источников.
Обеспечение авторитетности и достоверности
Каждый факт, который вы приводите, должен подкрепляться ссылкой на авторитетный источник. Это может быть государственная статистика, отчёты исследовательских компаний или публикации в рецензируемых журналах. LLM отдают приоритет документам, которые опираются на проверенные данные.
Явно указывайте автора и дату публикации в начале статьи. Это сигнал для модели, что контент имеет авторство и актуален. Если ваша статья обновляется, отображайте дату последнего обновления.
Обновление контента для поддержания актуальности
Создайте график обновления ключевых страниц. Раз в квартал проверяйте, не устарели ли цифры, не изменились ли законы или технологии. Обновлённый контент с новой датой публикации получает приоритет в глазах LLM.
По данным исследования AI GEO SEO, контент, обновляемый чаще одного раза в полгода, имеет на 30% больше шансов быть проиндексированным и использованным AI.
LLM учитывают не только дату публикации, но и частоту обновлений. Если вы регулярно вносите изменения, модель считает ваш ресурс активным источником. Это напрямую влияет на вероятность включения в ответы.
Антипаттерны: что мешает AI использовать ваш контент
Наряду с рекомендациями, важно знать, каких ошибок избегать.
Вот типичные антипаттерны, которые делают контент «невидимым» для LLM
- Сплошной текст без структуры — отсутствие заголовков, списков и таблиц. Модель «теряется» в большом объёме неструктурированного текста.
- Абстрактные формулировки — «много», «некоторые», «скорее всего». LLM требуют конкретных данных, а не размытых оценок.
- Сложные предложения — чрезмерное использование деепричастных оборотов и длинных вводных конструкций затрудняет парсинг.
- Отсутствие ссылок на источники — контент без ссылок выглядит менее авторитетным, особенно для моделей, настроенных на точность (например, Perplexity).
- Плагиат и низкая уникальность — AI-модели обучены распознавать неуникальный контент, поэтому компиляция чужих материалов без переработки не будет цитироваться.
- Устаревшая информация — LLM стремятся давать актуальные данные, поэтому контент с ошибками или старыми сведениями игнорируется.
- Массовая генерация без человеческой редакции — поисковые алгоритмы научились вычислять потоковые генерации и понижать их в ранжировании. Контент, созданный ИИ без добавления экспертизы, уникальных данных и проверки фактов, теряет позиции и не попадает в цитаты LLM.
Метрики видимости и цитируемости в GEO
Как измерить эффективность контента в мире LLM? Традиционные метрики — позиции, трафик, CTR — не работают. Нужны новые показатели.
Сравнение SEO и GEO
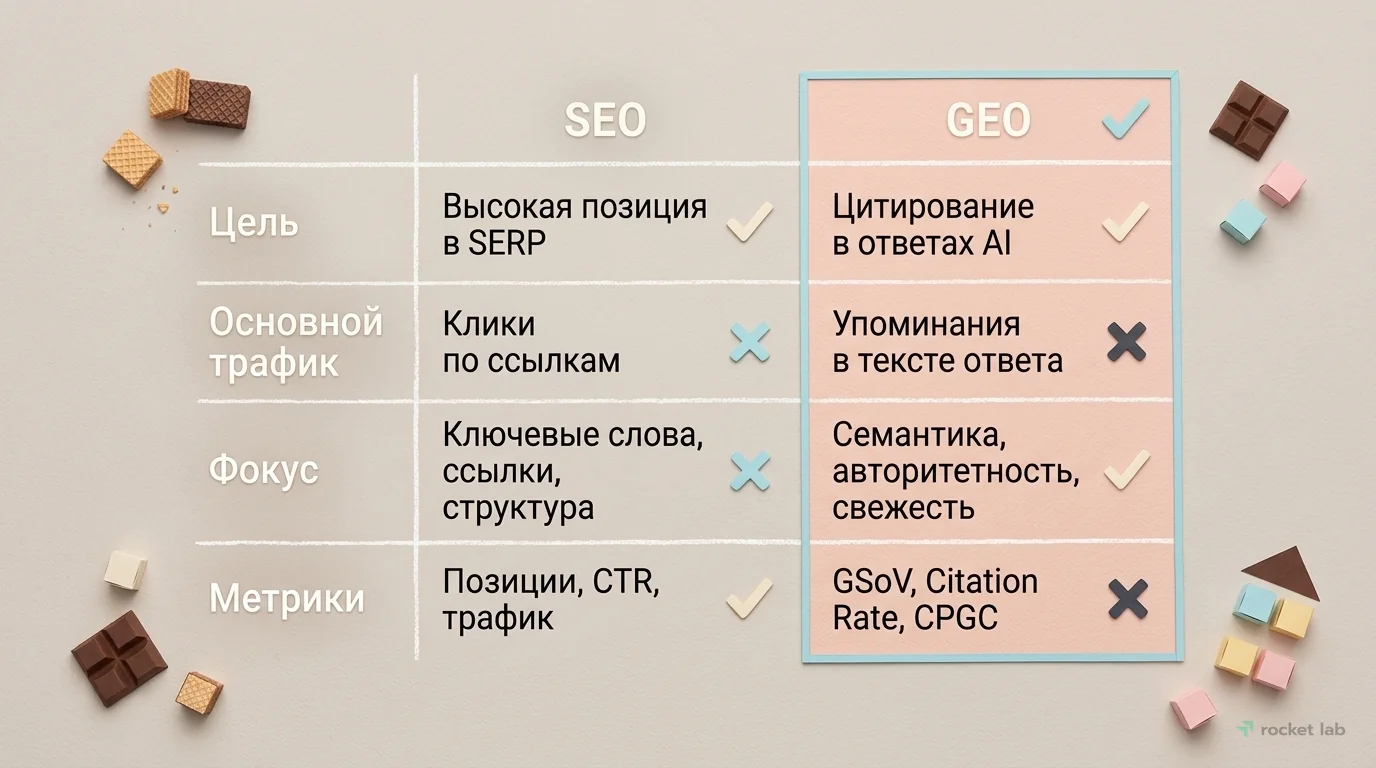
| Критерий | SEO | GEO |
|---|---|---|
| Цель | высокая позиция в SERP | цитирование в ответах AI |
| Основной трафик | клики по ссылкам | упоминания в тексте ответа |
| Фокус | ключевые слова, ссылки, структура | семантика, авторитетность, свежесть |
| Метрики | позиции, CTR, трафик | GSoV, Citation Rate, CPGC |
Доля генеративных упоминаний (GSoV)
GSoV (Generative Share of Voice) показывает, в скольких процентах ответов LLM на релевантные запросы упоминается ваш бренд или ваш сайт. Это аналог доли голоса в традиционном SEO, но применительно к генеративным движкам. Отслеживайте этот показатель по ключевым запросам вашей ниши.
Первое место в Google не гарантирует упоминание в ответе AI. Модель может выбрать источник с пятой страницы, если он лучше структурирован. Поэтому GSoV — более честная метрика видимости в новой реальности.
Индекс цитируемости (Citation Rate)
Citation Rate показывает, как часто ваш сайт выступает первоисточником данных для ответов LLM. Для расчёта нужен сбор данных по всем запросам, где модель использует информацию с вашего ресурса. Это можно делать вручную или с помощью специализированных инструментов.
Высокий индекс цитируемости говорит о том, что ваш контент содержит уникальные данные и удобно структурирован. Это также отражает доверие модели к вашему домену.
Семантическая близость (Semantic Proximity Score)
Модель хранит семантические связи между понятиями. Если ваш бренд тесно связан с определёнными категориями (например, «логистика», «B2B-доставка»), то при запросах в этих категориях ваш контент будет чаще выбираться. Этот показатель можно улучшить, последовательно создавая контент по одной тематике.
Semantic Proximity Score рассчитывается внутри многомерного пространства модели, поэтому его невозможно увидеть в стандартных SEO-инструментах. Однако вы можете косвенно оценивать его по частоте упоминаний в ответах AI.
Измерение «Стоимости генеративного контакта» (CPGC)
Когда AI даёт ответ без перехода на сайт, ценность клика снижается. CPGC (Cost per Generative Contact) показывает, сколько вы тратите на одно упоминание в ответе AI. Это помогает перераспределить бюджет на контент, который реально влияет на видимость, а не на бесполезные клики.
Сравнивая CPGC с традиционными показателями (например, стоимость лида), вы можете понять, выгодно ли вкладываться в контент-маркетинг. Если упоминание в AI-ответах приводит к росту брендовых запросов, это подтверждает ценность GEO-оптимизации.
Коэффициент положительной атрибуции (Positive Attribution Rate)
Эта метрика показывает, как часто нейросеть рекомендует ваш бренд в качестве решения проблемы, а не просто упоминает его в перечислении. Высокий коэффициент означает, что модель не только знает о вас, но и доверяет вам как эксперту. Отслеживание этого показателя позволяет понять, насколько ваш контент убеждает LLM рекомендовать вас.
Свежесть цитирования (Citation Freshness)
Метрика отражает, насколько свежие данные модель использует из вашего источника. Она напрямую связана с регулярностью обновлений и технической доступностью: если ваш сайт предоставляет данные через API или имеет часто обновляемую карту сайта (sitemap), вероятность того, что модель выберет именно вашу информацию как самую актуальную, возрастает. Citation Freshness становится решающим фактором в быстро меняющихся нишах.
Инструменты и подходы к анализу паттернов цитирования LLM
Чтобы понять, как LLM цитируют ваш контент, нужны специальные методы и инструменты.
Методология многократного синтетического тестирования
Составьте список из 50-100 запросов, которые ваша целевая аудитория может задавать LLM. Это должны быть не только точные формулировки, но и их вариации, синонимы, смежные темы. Чем шире набор, тем точнее вы оцените паттерны цитирования.
Для массовой оценки используйте подход LLM-as-a-Judge: вы отправляете запросы к тестируемой модели, собираете ответы, а затем просите другую модель (или ту же) оценить, какие источники были процитированы. Этот процесс можно автоматизировать и повторять регулярно.
Инструменты для анализа цитируемости
Некоторые сервисы, такие как Semrush и Ahrefs, начали добавлять данные о видимости в AI-ответах. Например, Semrush показывает, сколько раз ваш домен упоминается в ответах ChatGPT и Perplexity. Пока это базовые метрики, но они полезны для первичной оценки.
Показатели авторитетности домена (Domain Rating в Ahrefs, Domain Authority в Moz) коррелируют с частотой цитирования. Высокий DR не гарантирует попадания в LLM-ответы, но низкий почти исключает его. Регулярно отслеживайте эти метрики и работайте над ссылочным профилем.
Мониторинг и адаптация к региональной специфике моделей
Разные модели отдают предпочтение разным источникам. Например, ChatGPT чаще ссылается на англоязычные ресурсы, в то время как YandexGPT, GigaChat и Яндекс Нейро лучше работают с русскоязычным контентом. Изучите, какие типы сайтов чаще цитируются в вашей нише, и адаптируйте стратегию.
Мой совет — всегда учитывать региональную специфику и адаптировать контент для каждой LLM, если ваша аудитория распределена по разным гео.
Создавайте версии контента, оптимизированные под конкретные модели. Для международных LLM делайте упор на англоязычные источники и структуру, для российских — используйте больше ссылок на локальные издания и государственные ресурсы.
Что запомнить
Ключевые выводы для повышения LLM-видимости
- Оптимизируйте контент под семантическую полноту и авторитетность.
- Регулярно обновляйте данные и добавляйте оригинальные исследования.
- Используйте чёткую структуру: заголовки, списки, таблицы, определения.
- Внедряйте разметку Schema.org и создавайте граф-контент для улучшения семантической интерпретации.
- Отслеживайте новые метрики — GSoV, Citation Rate, CPGC, Positive Attribution Rate, Citation Freshness — и корректируйте стратегию.
- Не забывайте про техническую базу: headless CMS и доступность данных через API повышают шансы на цитирование.
Важность гибридного подхода человека и AI
Полностью перекладывать создание контента на AI не стоит. Модели генерируют обобщённые тексты, но уникальные экспертные знания остаются за человеком. Лучший подход — использовать LLM для черновиков и анализа, а финальную редакцию, проверку фактов и добавление уникальных данных делать вручную. Именно гибридные материалы чаще всего цитируются, потому что содержат и структуру, и глубину.
Предупреждения при работе с GEO
- GEO не заменяет SEO. Чтобы попасть в кандидаты на цитирование, страница должна хорошо ранжироваться в обычной выдаче.
- Не жертвуйте читабельностью ради структуры: если пользователям некомфортно читать текст, поведенческие метрики падают, и страница вылетает из топа, а значит и из поля зрения LLM.
- Сначала уникальные данные и инсайты, потом форматирование. Никакая микроразметка не спасёт пустой контент.
Будущее контент-стратегии для вашего бизнеса
В ближайшие годы цитируемость в LLM станет не менее важной, чем органический трафик. Контент-стратегия должна учитывать оба направления: классическое SEO для кликов и GEO для упоминаний в AI-ответах. Компании, которые начнут внедрять эти практики сейчас, получат конкурентное преимущество, когда генеративный поиск станет стандартом.
Частые вопросы (FAQ)
Чем GEO отличается от традиционного SEO?
GEO (оптимизация под генеративные движки) фокусируется на том, чтобы контент был включён в ответы LLM, а SEO — на ранжировании в списке ссылок. GEO требует работы с семантической полнотой, авторитетностью и структурой, а не только с ключевыми словами.
Какие типы контента LLM цитируют чаще всего?
Чаще всего цитируются материалы с уникальными данными, пошаговыми инструкциями, сравнительными таблицами и глубоким анализом. Также высокие шансы у свежих статей с чёткой структурой и указанием автора. Результаты собственных исследований и опросов ценятся особенно высоко.
Как проверить, цитирует ли LLM мой контент?
Самый простой способ — задавать релевантные запросы в ChatGPT, YandexGPT, Яндекс Нейро и других моделях, затем искать упоминания вашего бренда или сайта. Более систематический подход — использовать специализированные инструменты, такие как Semrush, которые показывают видимость в AI-ответах.
Нужно ли переписывать весь контент под LLM?
Нет, достаточно оптимизировать ключевые страницы, которые приносят основной трафик. Начните с самых важных продуктовых и экспертных материалов. Приоритет — страницы с высокой информационной ценностью, которые могут быть использованы как первоисточники.
Какие ошибки чаще всего совершают при оптимизации контента для AI?
Главная ошибка — игнорирование структуры и попытка «нашпиговать» текст ключевыми словами. Также вредят отсутствие дат, авторов и ссылок на источники. Многие переписывают контент без добавления уникальных данных, что снижает его ценность для LLM. Наконец, не стоит забывать о регулярном обновлении — устаревшие материалы модель отбрасывает.