

A/B-тестирование — это метод сравнения двух версий одного элемента (страницы, заголовка, кнопки, письма) для выявления наиболее эффективной. Оно позволяет принимать решения на основе данных, а не интуиции, увеличивая конверсию, продажи и удовлетворённость клиентов. В этом руководстве — пошаговая инструкция, примеры, инструменты и типичные ошибки, которые помогут вашему бизнесу расти через постоянные эксперименты.
Что такое A/B-тестирование и зачем оно нужно
Суть метода
A/B-тестирование (или сплит-тестирование) — это контролируемый эксперимент, в котором аудитория случайным образом делится на две группы: контрольную (вариант А) и тестовую (вариант Б). Каждая группа видит свою версию одного и того же элемента. Затем вы сравниваете заранее выбранные метрики — конверсию, клики, время на странице, количество заявок — и смотрите, какой вариант сработал лучше.
Главное правило — менять только один элемент за раз. Если вы измените заголовок и кнопку одновременно, вы не поймёте, что именно повлияло на результат. Тест должен быть изолированным.
A/B-тестирование — это системный подход к улучшению продукта на основе данных.

Откуда взялся метод
Корни A/B-тестирования лежат в научных экспериментах. В сельском хозяйстве и медицине сравнивали эффективность разных методов лечения или удобрений. Первый известный контролируемый эксперимент с разделением групп провёл в 1747 году шотландский хирург Джеймс Линд, сравнивая методы лечения цинги у моряков. В XX веке британский статистик Рональд Фишер сформулировал принципы рандомизированных контролируемых испытаний, а в 1948 году провели первый такой тест для оценки стрептомицина против туберкулёза. Ещё раньше, в начале XX века, математик Вильям Госсет применял A/B-тестирование при производстве пива Guinness, сравнивая разные сорта ячменя.
С развитием интернета в 1990-х годах метод адаптировали для веб-сайтов. В начале 2000-х Google протестировал 41 оттенок синего для ссылок в поисковой выдаче, чтобы найти самый кликабельный, а Microsoft начала масштабно использовать A/B-тесты для оптимизации интерфейсов. Сегодня это стандарт для любой компании, которая хочет принимать решения на основе данных, а не мнения начальника.
Какие задачи решает A/B-тестирование
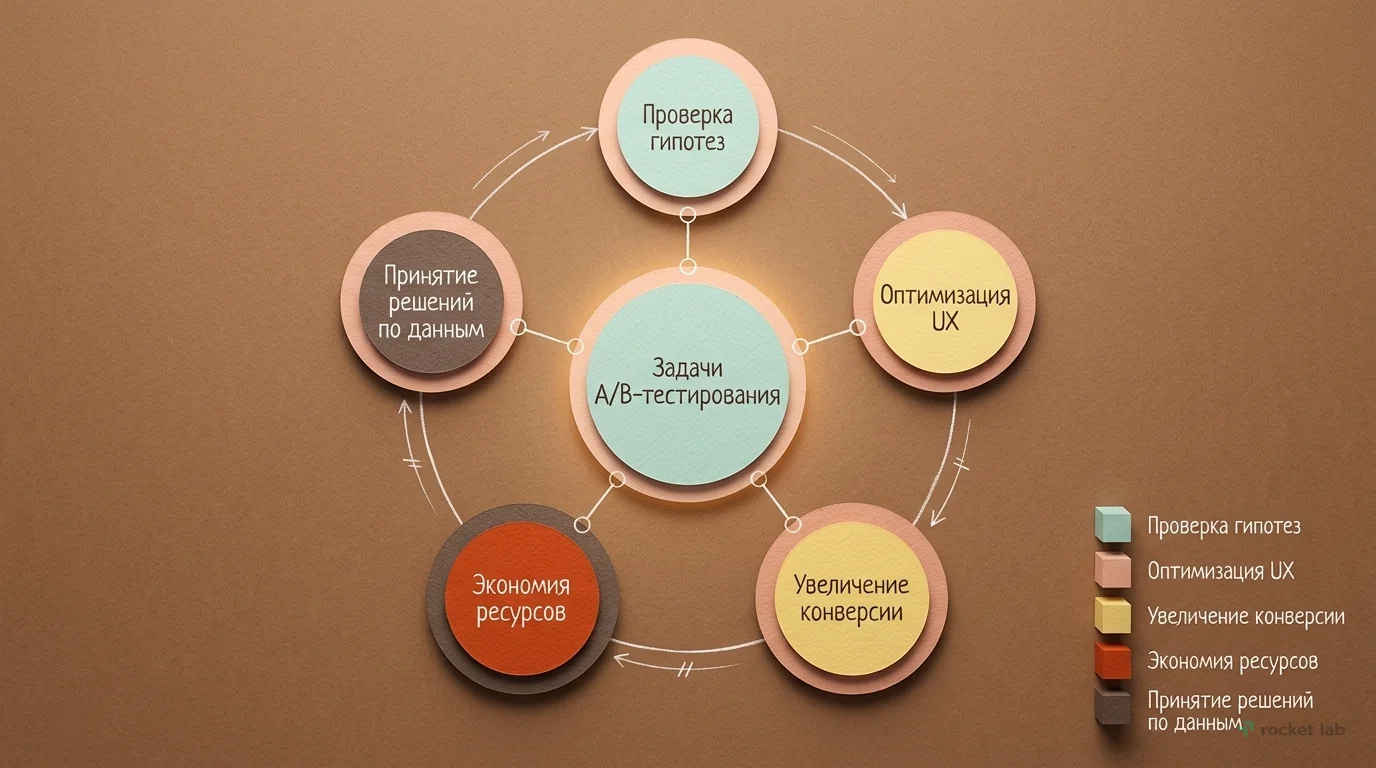
- Проверка гипотез до внедрения. Вы можете оценить влияние изменения на небольшой выборке пользователей, не рискуя всей аудиторией. Например, производственная компания, запускающая новый онлайн-каталог, может протестировать два варианта отображения цен — с указанием стоимости в рублях и с ценой «от» — чтобы понять, какой стимулирует больше запросов.
- Оптимизация пользовательского опыта. Юридическая фирма может протестировать разные структуры страницы услуг, чтобы клиенты быстрее находили нужную информацию.
- Увеличение конверсии, среднего чека, удержания. Онлайн-школа тестирует формулировки призыва к действию на странице курса — «Записаться сейчас» или «Получить программу» — и выбирает более результативную.
- Экономия ресурсов. Вместо дорогостоящей разработки новой функции вы сначала проверяете её эффективность на простом прототипе или изменении текста. Это особенно ценно для компаний с ограниченным бюджетом, где каждый рубль должен приносить ROI.
- Принятие решений на основе данных. Вы заменяете споры «я думаю, так лучше» на объективные цифры о поведении реальных пользователей.
Какие задачи решает A/B-тестирование
Кому подходит A/B-тестирование
Метод полезен маркетологам — для оптимизации рекламных объявлений, заголовков, текстов, лид-форм и воронок продаж. Владельцам сайтов и приложений — для улучшения UX/UI дизайна, интерфейса, структуры страниц. Руководителям продуктов — для проверки новых функций и идей. Аналитикам — для оценки эффективности изменений и подтверждения гипотез.
При этом метод может быть неэффективен на старте бизнеса: при нулевой посещаемости собрать статистически значимую выборку не получится. Он не подходит при жёстких сроках, когда полноценный запуск невозможен. А когда нужно понять мотивацию клиентов, лучше подходят глубинные интервью и фокус-группы. A/B-тест показывает «что» работает, но не объясняет «почему».
Виды A/B-тестов
Классическое A/B-тестирование
Сравнение двух версий (А и Б) одного элемента. Самый простой и распространённый вид. Подходит для тестирования заголовков, кнопок, изображений, текста объявлений. Не требует сложной настройки, быстро запускается.
A/A-тестирование
Две идентичные версии. Используется для проверки корректности системы тестирования: равномерно ли распределяется трафик, правильно ли собираются данные. Если в A/A-тесте вы видите значимую разницу, значит, есть техническая ошибка.
Перед первым боевым A/B-тестом рекомендуется провести короткий A/A-тест, чтобы проверить корректность сплитования (SRM). Если план был 50/50, а фактическое распределение системно уходит в сторону — это признак сбоя рандомизации или фильтрации ботов. Также проверьте, что цели и события одинаково срабатывают в обеих группах, а скорость загрузки версий сопоставима. Если A/A-тест показал SRM, сначала устраните причину и только после успешного повторного теста запускайте боевой эксперимент.
A/A/B-тестирование
Расширенный A/A-тест: две контрольные группы (А и А) и одна тестовая (Б). Позволяет в реальном времени отслеживать качество распределения трафика и выявлять искажения, сохраняя статистическую значимость.
A/B/n-тестирование
Сравнение более двух вариантов (А, Б, В, Г). Подходит, когда нужно проверить несколько конкурирующих гипотез одновременно. Требует больше трафика, но даёт более полную картину. Например, можно тестировать пять вариантов заголовка и выбрать лучший.
Мультивариантное тестирование (MVT)
Проверка нескольких элементов и их комбинаций в одном тесте. Например, компания по ремонту техники тестирует одновременно текст кнопки и изображение мастера, чтобы найти наилучшую комбинацию. MVT требует значительно больше трафика и времени, поэтому подходит для сайтов с высокой посещаемостью. Если вы подготовили по три варианта заголовка, баннера и кнопки, количество комбинаций составит 27 (3 × 3 × 3), и для каждой понадобится отдельная группа пользователей.
Switchback-эксперименты
Чередование разных версий во времени или по локациям. Используется, когда пользователи могут влиять друг на друга (например, в социальных сетях или маркетплейсах). Позволяет избежать «перетекания» пользователей между группами и эффекта переноса (carryover), когда поведение в одном периоде влияет на реакцию в последующем. Сетевые взаимодействия, когда действия одних участников меняют поведение других, также требуют такого подхода — в классическом параллельном тесте они искажают результаты.
Ухудшающие A/B-тесты
Этот приём используют, чтобы проверить чувствительность системы тестирования. Вместо ожидаемого улучшения запускают заведомо плохой вариант (например, убирают важный элемент интерфейса). Если система не обнаруживает ухудшения, значит, она недостаточно чувствительна и её настройки нужно калибровать. Такие тесты помогают убедиться, что платформа способна отличить реальный эффект от шума.
Последовательные (турнирные) тесты
Вместо одновременного сравнения всех версий можно тестировать гипотезы по очереди: сначала сравнивают варианты А и Б, победитель проходит в следующий раунд с версией В. Такой подход подходит, когда трафика мало, нужно снизить финансовые риски или гипотезы зависят друг от друга. В каждый момент времени сравниваются только две версии, но эксперимент длится дольше классического.
Многорукие бандиты (MAB)
Адаптивный алгоритм, который в реальном времени распределяет трафик в пользу более эффективного варианта. Вместо фиксированного разделения 50/50 система постепенно направляет больше пользователей к лидеру, сокращая потери на проигрышном варианте. Подходит для сценариев, где важна скорость получения результата и не требуется классический статистический вывод.
Как проводить A/B-тестирование: пошаговая инструкция
Пошаговая инструкция A/B-тестирования
Шаг 1: Формулирование гипотезы и постановка целей
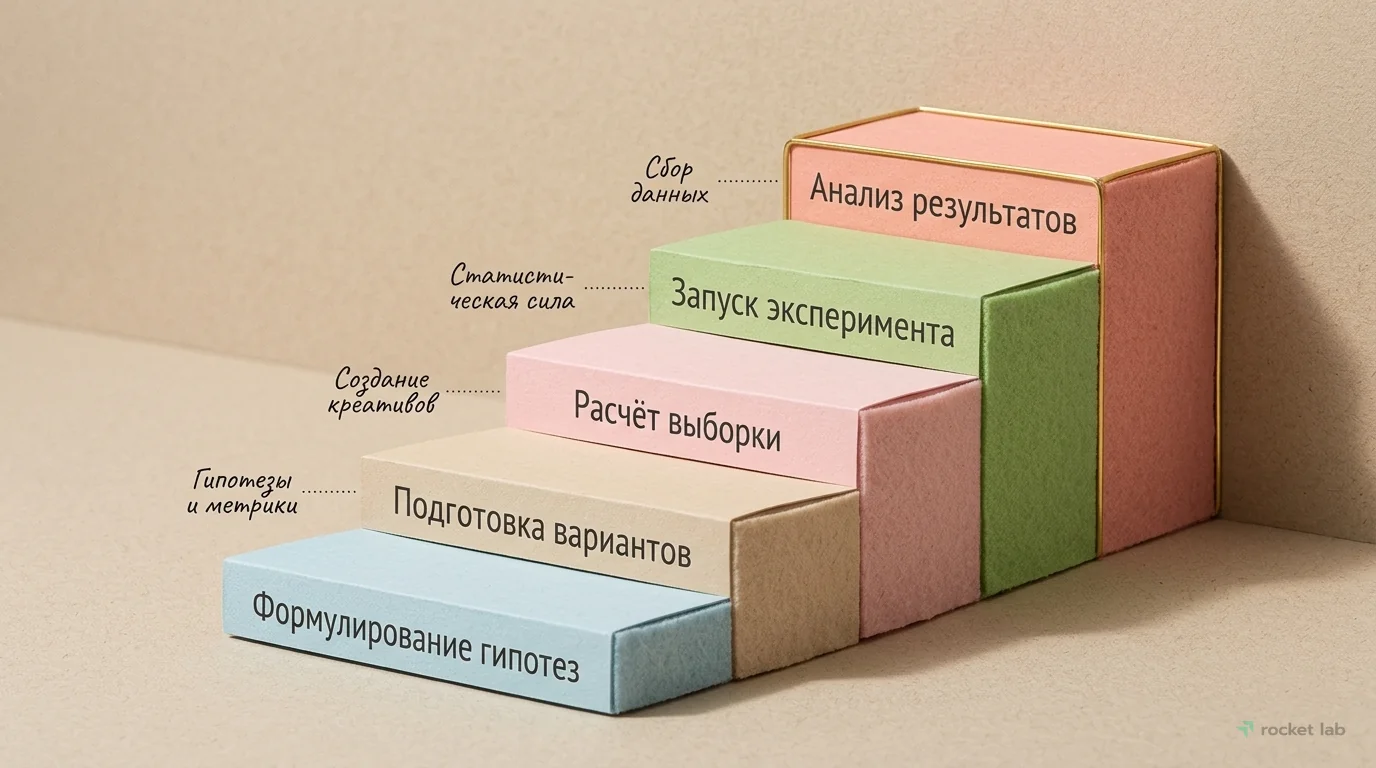
Начните с определения проблемы. Например, у вас низкая конверсия в заявки на демо-версию для B2B-сервиса. Сформулируйте гипотезу: «Если мы упростим форму обратной связи (уберём поле “телефон”), то количество заявок вырастет на 10%». Формально различают нулевую гипотезу (изменения не влияют на показатели) и альтернативную (влияют). Задача теста — отвергнуть нулевую гипотезу. Выберите основную метрику (например, число отправленных заявок) и защитные метрики (время на сайте, отказы), чтобы убедиться, что вы не улучшаете одну метрику в ущерб другой.
Формулируйте гипотезу по схеме «Действие → Результат → Причина»: «Если мы изменим X, то метрика Y вырастет на Z%, потому что…». Опирайтесь на объективные данные: отчёты аналитики, тепловые карты, записи сессий. Гипотеза должна быть согласована с глобальной целью компании: если цель — увеличение продаж, не стоит тестировать изменения, которые не влияют на этот показатель. Также определите тип теста: односторонний (проверяет изменение только в одну сторону — улучшение) или двусторонний (учитывает и улучшение, и ухудшение).
Для выбора приоритетной гипотезы используйте фреймворки ICE (Impact, Confidence, Ease) или PIE (Potential, Importance, Ease): оцените каждую гипотезу по шкале от 1 до 10, перемножьте баллы и выберите вариант с максимальным значением. Это поможет сфокусироваться на самых перспективных экспериментах, не распыляя ресурсы на слабые идеи.
Шаг 2: Подготовка вариантов и определение аудитории
Создайте две версии: А — текущая, Б — с изменением. Меняйте только один элемент. Например, автосервис тестирует кнопку «Записаться на ТО» с разными текстами: «Записаться» и «Узнать стоимость». Определите целевую аудиторию: все посетители или только новые, только с мобильных устройств, из определённого региона. Распределение должно быть случайным и равномерным (50/50). Чтобы снизить риски, рекомендуется выделять под эксперимент не более 5–10% трафика — этого достаточно для получения данных, но негативный результат не скажется на основном потоке.
Важно, чтобы состав групп соответствовал генеральной совокупности: если аудитория сайта — 80% женщин и 20% мужчин, такое же соотношение должно сохраняться в тесте, иначе результаты будут некорректны. Полезно также выделить контрольную группу, которая не увидит ни один из вариантов, чтобы отслеживать естественный уровень конверсии и исключить влияние внешних факторов.
Также убедитесь, что сравниваемые варианты достаточно различаются. Если тестировать, например, светло-синюю и тёмно-синюю кнопку, вероятность обнаружить значимую разницу крайне мала — для такого микроизменения потребуется огромная выборка. Тест эффективен, когда гипотеза предполагает ощутимое изменение поведения.
Шаг 3: Расчёт выборки и длительности теста
Рассчитайте минимальный размер выборки и длительность. Используйте калькуляторы статистической значимости (например, в Яндекс.Метрике). Известен также калькулятор Эвана Миллера, который позволяет рассчитать необходимое количество показов. Ключевой параметр расчёта — минимальный детектируемый эффект (MDE): минимальное улучшение, которое вы хотите обнаружить. Например, при базовой конверсии 3% и желании зафиксировать рост на 10% (до 3,3%) при уровне значимости 5% и мощности 80% понадобится примерно 35–40 тысяч сессий на каждую группу.
Не копируйте чужие цифры MDE или выборки — они зависят от вашего трафика и базовой конверсии. В качестве ориентира для минимального объёма показов можно использовать 10 000 на каждую группу — при меньшем трафике результаты редко бывают статистически значимыми. Учитывайте недельный цикл: тест должен длиться минимум 7 дней, лучше 14, чтобы охватить все дни недели. Размер выборки обычно составляет 2–30% от генеральной совокупности пользователей. Не затягивайте тесты более 28 дней — из-за «вымывания» cookie состав групп искажается, а поведение аудитории меняется. Не останавливайте тест раньше времени, даже если кажется, что один вариант явно лидирует — это ошибка подглядывания.
Шаг 4: Запуск эксперимента и сбор данных
Настройте тест в выбранном инструменте. В первые дни следите за технической корректностью: равномерность распределения трафика (SRM), отсутствие ошибок в коде, корректный сбор данных. Перед запуском убедитесь, что обе версии загружаются одинаково быстро — разница в скорости может исказить результат. Также проверьте, какие данные собирает платформа и есть ли правовое основание для обработки персональных данных пользователей.
Обратите внимание на проблему «мерцания»: при загрузке страницы пользователь может на мгновение увидеть оригинальную версию до применения изменений. Это искажает восприятие и может повлиять на поведение. Используйте код, который скрывает страницу до начала работы тестирования (например, анти-мерцающий код Google Optimize), чтобы обеспечить чистоту эксперимента.
Важно тестировать оба варианта одновременно, а не последовательно. Если показывать вариант А в одну неделю, а вариант Б — в другую, на результаты повлияют изменения внешней среды (сезонность, рекламные кампании, действия конкурентов). Одновременный показ гарантирует, что обе группы находятся в одинаковых условиях. Также учитывайте периоды, когда активность аудитории нестабильна: если в выходные клики резко падают, а в будни — стабильны, лучше проводить тест по будням, чтобы не получить искажённые данные.
Шаг 5: Анализ результатов и принятие решений
После сбора данных сравните метрики. До анализа проверьте качество эксперимента: соотношение пользователей в группах соответствует плановому, данные собирались одинаково без потерь, не было технических сбоев и внешних изменений. Проверьте статистическую значимость (p-value < 0.05). Оцените практическую значимость: даже если разница статистически значима, она может быть слишком мала для внедрения. Проанализируйте результаты по сегментам: устройства, источники трафика, география. Например, рекламное агентство может обнаружить, что новый креатив лучше работает на мобильных, но хуже на десктопе — тогда стоит применить его только для мобильной аудитории. Примите решение: внедрить победителя, скорректировать гипотезу или запустить новый тест.
Для оценки общей ценности изменения используйте единую метрику эксперимента (Overall Evaluation Criterion, OEC) — взвешенную комбинацию нескольких целей, которая даёт однозначный ответ, перевешивают ли выгоды затраты. OEC устраняет конфликты, когда одни метрики растут, а другие падают, и позволяет принимать решения без субъективных компромиссов.
Помните о законе Тваймана: если результат выглядит слишком хорошо, чтобы быть правдой, скорее всего, в эксперименте ошибка. Например, аномальный рост конверсии может быть вызван двойным биллингом или сбоем в сборе данных. Прежде чем радоваться, проверьте, не является ли «фантастический» результат артефактом. Реверс одного неверного решения может окупить всю команду аналитиков.
Для повышения точности при ограниченном трафике используйте метод CUPED (Controlled-experiment Using Pre-Experiment Data). Он снижает дисперсию метрик примерно на 50%, используя данные, собранные до начала теста. Это эквивалентно удвоению выборки или сокращению длительности эксперимента вдвое — особенно полезно, когда трафик ограничен.
Дополнительно: если продукт имеет длинный цикл принятия решения (например, недвижимость, B2B-услуги), основная метрика (количество заявок) может не успеть измениться за время теста. В таких случаях выбирайте дополнительные прокси-метрики — просмотры страниц, клики, время на сайте, — которые быстрее реагируют на коммуникацию. Рост этих метрик сигнализирует о том, что изменение работает, даже если прямые лиды ещё не успели вырасти.
Шаг 6: Дополнительные рекомендации после теста
Если разница получилась неожиданно большой, полезно повторить тест на новой выборке, чтобы убедиться, что результат воспроизводится. Если статистически значимого улучшения нет, это тоже результат: возможно, выборки не хватило или метрика оказалась слишком шумной. Выводы стоит делать с учётом объёма данных, а не только по итоговым цифрам.
Организуйте процесс тестирования как систему: ведите календарь экспериментов, чтобы не запускать конкурирующие тесты одновременно, и базу знаний, где фиксируйте каждую гипотезу, результаты, скриншоты и принятые решения. Это позволяет учиться на ошибках, избегать повторных экспериментов и накапливать экспертизу внутри команды.
По мере роста зрелости команды стоит задуматься о создании собственной внутренней платформы для экспериментов. Такая платформа автоматизирует рутинные процессы: распределение трафика, сбор метрик, проверку статистической значимости, контроль качества. Крупные компании (Google, Microsoft, Booking.com) ежегодно проводят более 20 000 контролируемых экспериментов именно благодаря масштабируемой инфраструктуре, которая снижает предельную стоимость каждого теста почти до нуля. Даже для среднего бизнеса внедрение подобных инструментов окупается за счёт скорости и надёжности принятия решений.
Инструменты для A/B-тестирования
Выбор инструмента зависит от ваших задач, бюджета и технических возможностей. Ниже — таблица популярных платформ, доступных в России.
Выбор инструмента должен основываться на ваших задачах и бюджете, а не на популярности.
| Название | Тип бизнеса | Цена от | Ключевая особенность |
|---|---|---|---|
| Яндекс Метрика | любой | бесплатно | встроенные эксперименты |
| Битрикс24 | малый, средний | от 990₽/мес | A/B-тесты в CRM и рассылках |
| VWO | средний, крупный | от $99/мес | мультивариантное тестирование |
| Optimizely | крупный | по запросу | масштабируемые эксперименты |
| AB Tasty | средний | от $99/мес | персонализация и тесты |
| Tilda | малый, e-commerce | от 750₽/мес | A/B-тесты на лендингах |
| Unisender | малый, средний | от 10₽/письмо | A/B-тесты в email-рассылках |
| SendPulse | малый, средний | от 20₽/письмо | A/B-тесты в email и push |
| LPgenerator | малый, средний | от 990₽/мес | A/B-тесты на посадочных страницах |
| Convert | средний | от $99/мес | фокус на оптимизации конверсии |
| Trisigma | средний, крупный | по запросу | автоматизация A/B-тестов и продуктовая аналитика |
Встроенные инструменты аналитических систем
Яндекс Метрика — бесплатный инструмент, который позволяет проводить A/B-тесты прямо в интерфейсе. Вы создаёте эксперимент, выбираете страницу и варианты, задаёте цель. Метрика сама распределяет трафик и показывает статистическую значимость. Отлично подходит для небольших сайтов.
Google Analytics не имеет встроенного A/B-тестирования, но его можно использовать для сбора данных и анализа результатов, если вы настроите эксперимент через сторонний сервис.
CRM-системы с функцией A/B-тестирования
Битрикс24 — популярная CRM в России, которая включает модуль A/B-тестирования для лендингов, рассылок и форм. Можно тестировать разные варианты писем, заголовков и текстов в рамках воронки продаж.
Специализированные платформы
VWO — платформа для A/B, A/B/n и MVT-тестов. Поддерживает сегментацию, персонализацию, анализ воронок. Подходит для средних и крупных компаний.
Optimizely — корпоративное решение для крупного бизнеса. Масштабируемые эксперименты на сайтах, в мобильных приложениях, серверная и клиентская стороны.
AB Tasty — платформа с уклоном в персонализацию. Позволяет создавать персонализированные версии страниц для разных сегментов и тестировать их.
Tilda — конструктор лендингов с встроенным A/B-тестированием. Удобно для быстрого тестирования страниц без глубоких технических знаний.
Unisender — сервис email-маркетинга, который позволяет тестировать темы писем и контент. Подходит для малого бизнеса.
SendPulse — ещё один сервис для email-рассылок с A/B-тестированием, а также push-уведомлений.
LPgenerator — платформа для создания посадочных страниц с возможностью A/B-тестов.
Convert — специализированный инструмент для оптимизации конверсии, поддерживает тесты на основе данных. Позволяет отслеживать ROI и CPA по каждому варианту.
Trisigma — российская платформа от AvitoTech для автоматизации A/B-тестирования и комплексной продуктовой аналитики. Позволяет проектировать эксперименты, анализировать результаты и визуализировать данные в едином интерфейсе. Подходит для средних и крупных компаний, которым нужна глубокая интеграция с внутренними данными и высокая скорость проведения тестов.
Для базовых задач также подойдут бесплатные инструменты: Microsoft Clarity (запись сессий, тепловые карты, не требует интеграции с аналитикой) и Firebase A/B Testing (для мобильных приложений на платформе Firebase). Они особенно полезны, когда нужно быстро проверить гипотезу без затрат на платные платформы.
Распространённые ошибки в A/B-тестировании
Ошибки на этапе подготовки
Распространенные ошибки в A/B-тестировании: айсберг проблем
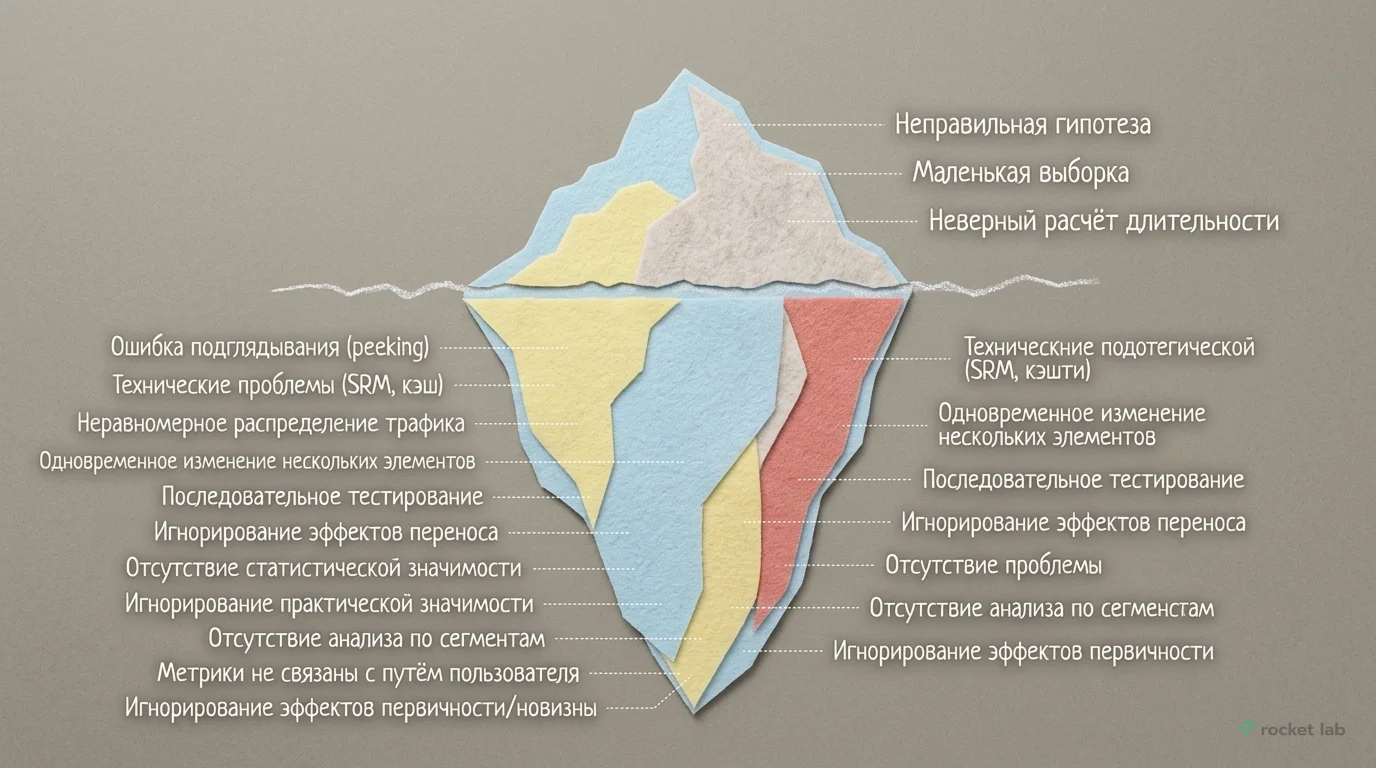
Неправильная гипотеза — одна из самых частых проблем. Проверка нескольких изменений одновременно или отсутствие чёткой гипотезы. Например, B2B-компания с небольшим трафиком решает тестировать два разных макета страницы — это требует слишком много времени для получения данных.
Маленькая выборка. Для статистически значимого результата нужно достаточно посетителей. Если трафик низкий, тест займёт месяцы или вообще не даст результата.
Неверный расчёт длительности. Остановка теста до набора нужного объёма данных или слишком длинный тест, который теряет актуальность (например, из-за сезонности).
Игнорирование сезонности и внешних факторов. Если вы проводите тест во время распродаж или праздников, данные будут искажены.
Запуск теста, когда можно обойтись более простыми методами. Сначала оцените, действительно ли нужен A/B-тест: возможно, гипотезу проще проверить постепенной раскаткой изменения или экспертной оценкой.
Тестирование слишком похожих вариантов. Если изменения минимальны (например, оттенок кнопки), потребуется огромная выборка, чтобы зафиксировать разницу, и тест, скорее всего, окажется нерезультативным.
Ошибки во время проведения
Ошибка подглядывания (peeking). Преждевременный просмотр результатов и остановка теста. Это ведёт к ложным выводам, так как разница может быть случайной. Остановка теста оправдана только в исключительных случаях: если эксперимент ухудшает ключевые метрики, вызывает технические проблемы или заметно портит пользовательский опыт.
Технические проблемы. К типичным техническим ошибкам относятся: показ закешированной старой версии страницы, блокировка события аналитики блокировщиком рекламы, сбой cookie, из-за которого пользователь попадает в другую группу, разрыв сессии или ошибка передачи идентификатора между доменами. Также событие может отправиться в аналитику до того, как система назначила пользователю вариант теста. Всегда проверяйте, что версии действительно показываются разным группам.
Неравномерное распределение трафика. Если одна группа получает значительно больше пользователей, тест некорректен.
Одновременное изменение нескольких элементов. Невозможно понять, что именно повлияло на результат.
Последовательное тестирование вместо одновременного. Если показывать варианты в разные периоды, на результаты повлияют изменения внешней среды.
Игнорирование эффектов переноса и сетевых взаимодействий. В маркетплейсах, социальных сетях и других средах, где пользователи влияют друг на друга, параллельные группы могут «заражать» друг друга, искажая результат. Здесь нужны switchback-эксперименты или кластеризация по изолированным сегментам.
Ошибки при анализе
Отсутствие статистической значимости. Принятие решения на основе случайных колебаний. Всегда проверяйте p-value.
Игнорирование практической значимости. Даже если разница статистически значима, она может быть несущественна для бизнеса. Например, +0,5% конверсии может не стоить усилий.
Отсутствие анализа по сегментам. Упущение полезных эффектов для отдельных групп пользователей или негативного влияния на другие. Строительная бригада, тестирующая новый дизайн кнопки «Заказать смету», может обнаружить, что она лучше работает для клиентов из поиска, но хуже для клиентов по рекомендациям. Будьте осторожны с парадоксом Симпсона: общий результат может быть противоположен результатам в отдельных сегментах. Всегда разбивайте данные по устройствам, источникам трафика и географии, чтобы увидеть полную картину.
Метрики не связаны с реальным пользовательским путём. Рост кликов без влияния на продажи или удержание — ложный сигнал. Убедитесь, что выбранные метрики отражают бизнес-результат.
Игнорирование эффектов первичности и новизны. Пользователи могут предпочитать привычный вариант (первичность) или, наоборот, остро реагировать на новизну (новизна), что искажает результаты. Для выявления этих эффектов сравнивайте поведение пользователей в разные периоды теста — если эффект ослабевает со временем, возможно, он вызван реакцией на новизну.
Никогда не останавливайте тест, пока не наберётся статистически значимая выборка.
Что запомнить
- Используйте A/B-тестирование для принятия решений на основе данных, а не интуиции.
- Формулируйте чёткую гипотезу и выбирайте одну основную метрику.
- Обеспечьте достаточный объём выборки и длительность теста (минимум 7-14 дней).
- Избегайте ошибок подглядывания и проверяйте техническую корректность эксперимента.
- Проводите A/A-тесты для проверки системы и анализируйте результаты по сегментам.
- Перед запуском проверяйте скорость загрузки версий и правовые аспекты обработки данных.
- При неожиданно большом результате повторяйте тест для подтверждения.
- Используйте единую метрику эксперимента (OEC) и метод CUPED для повышения точности.
- Тестируйте варианты одновременно и выбирайте периоды со стабильной активностью аудитории.
- Учитывайте эффекты переноса и сетевые взаимодействия в средах, где пользователи влияют друг на друга.
Частые вопросы (FAQ)
Что такое A/B-тестирование простыми словами?
A/B-тестирование — это эксперимент, в котором двум группам пользователей показывают разные версии одного элемента (например, кнопки или заголовка), чтобы выяснить, какая версия приводит к лучшему результату (конверсии, кликам и т.д.). Это способ принимать решения на основе реальных данных, а не предположений.
Как долго нужно проводить A/B-тест?
Минимальная длительность — 7 дней, чтобы учесть недельный цикл поведения пользователей. Рекомендуется 14 дней, особенно если трафик невысокий. Тест должен длиться до достижения статистической значимости, но не дольше 4-6 недель, чтобы данные не устарели.
Какие элементы сайта можно тестировать?
Практически любые: заголовки, тексты, кнопки, формы, изображения, расположение элементов, цены, призывы к действию, дизайн страниц. Также можно тестировать элементы email-рассылок: темы, превью, содержание.
Что такое статистическая значимость и почему она важна?
Статистическая значимость — это вероятность того, что разница между вариантами не случайна. Обычно используют порог 5% (p-value < 0,05). Если значимость не достигнута, нельзя утверждать, что победивший вариант действительно лучше.
Можно ли проводить A/B-тесты с небольшим трафиком?
Да, можно, но нужно быть готовым к длительному тесту. При малом трафике увеличьте длительность или рассмотрите A/A-тесты для проверки системы. В некоторых случаях лучше фокусироваться на качественных изменениях, а не на тонких настройках.